다양한 산업에서 AI 시스템이 중요한 의사결정을 좌우하는 시대에 접어들면서 소버린 AI 은 중요한 전략적 과제로 떠오르고 있습니다. 각국이 항만, 전력망, 통신 인프라와 같은 핵심 국가 기반 시설을 보호하듯이, 이제 AI 인프라 또한 동일한 수준의 보호와 통제가 필요하다는 인식이 확산되고 있습니다.
이번 글에서는 LTS Group과 함께 AI 소버린의 개념, 작동 원리, 이점, 도전 과제 및 글로벌 현황을 살펴보고자 합니다. EU, 북미와 같은 주요 블록부터 한국과 같은 아시아 대표 국가들까지 다양한 사례를 다루며 소개합니다. 이를 통해 AI 소버린이 왜 오늘날 전 세계적으로 가장 중요한 전략적 우선순위 중 하나로 떠오르고 있는지 종합적으로 이해할 수 있을 것입니다.
소버린 AI란 무엇입니까?
소버린 AI(Sovereign AI)는 데이터, 기술, 운영, 법적 구조 측면에서 일정 수준의 독립성을 가진 AI 시스템을 구축하고 운영하는 것을 의미합니다. 관점에 따라 이해 방식이 달라질 수 있습니다. 정부 입장에서는 소버린 AI가 국가 안보와 국내 경제 전략에 중점을 두는 반면, 기업 리더들은 운영 및 기술 자율성을 더 강조하는 경우가 많습니다.
소버린 AI의 핵심은 국가가 AI 시스템을 직접 통제하고 운영한다는 점이며, 중요한 요소로는 데이터 주권과 전략적 자율성이 포함됩니다. 목표는 외국 클라우드 서비스나 대형 기술 기업의 AI 모델에 의존하지 않고, 해당 국가의 법률, 문화, 안보 요구를 반영한 독립적인 생태계를 구축함으로써 국가적 위험을 최소화하는 것입니다.
일반적으로 다음 네 가지 요소가 소버린 AI의 범위를 정의하는 기준으로 활용됩니다.
영토적 측면(Territorial): 데이터와 컴퓨팅 자원이 물리적으로 어디에 위치하는가
운영적 측면(Operational): 데이터와 컴퓨팅 인프라를 누가 관리하고 보호하는가
기술적 측면(Technological): 기술 플랫폼과 지식재산권을 누가 소유하는가
법적 측면(Legal): 데이터 접근 및 규제 준수를 어떤 법적 관할권이 관리하는가
소버린 AI(Sovereign AI)이 주목받는 가운데, 주권 클라우드(Sovereign Cloud) 역시 자주 언급되며 중요한 논의 주제로 떠오르고 있습니다.
주권 클라우드는 데이터를 국가 경계 내에서 완전히 저장하고 처리하도록 설계된 클라우드 컴퓨팅 서비스로, 국내 법률과 보안 정책을 준수하도록 보장합니다.
이를 통해 국가와 기업은 민감한 데이터를 통제하고, 외부로 유출되거나 악용될 위험을 줄일 수 있으며, 자국 인프라와 데이터를 기반으로 소버린 AI를 구현할 수 있습니다. 따라서 소버린 클라우드는 개인정보를 보호하는 동시에 기술 주권과 국가 안보를 강화하는 역할을 합니다.
소버린 AI의 이점
AI 독립 역량에 투자하는 조직과 국가는 단순한 기술 자립을 넘어 다양한 전략적·운영적 이점을 얻을 수 있습니다.
소버린 AI의 이점
데이터 주권 강화 및 국가 안보 보호
소버린 AI은 데이터 주권을 강화하고 국가 안보를 보호하는 데 중요한 역할을 합니다. 한 국가가 자국의 인프라, 내부 데이터, 인재, 그리고 비즈니스 네트워크를 기반으로 AI를 개발할 경우, 민감한 데이터가 해외 시스템에서 저장되거나 처리되는 것을 방지할 수 있습니다.
소버린 AI는 국가가 내부 데이터와 AI 인프라를 직접관리하고 통제할 수 있도록 돕습니다. 민감한 데이터가 국내 시스템에서 수집, 저장, 처리될 경우, 해당 국가는 데이터가 해외로 유출되거나 무단으로 사용되는 것을 방지할 수 있습니다. 일부 국가들은 주권형 클라우드를 도입하여 국가 데이터를 자국 영토 내에 저장하고, 관리 권한을 강화하며 정보 유출 위험을 줄이고 있습니다.
소버린 AI는 또한 외부 위협과 데이터 남용 위험을 최소화합니다. AI와 국가 데이터베이스가 국내에서 관리될 경우, 외부 시스템으로부터의 해킹이나 데이터 악용 가능성이 제한됩니다. 특히 국방 AI(Defense AI) 분야에서 의사결정을 지원하고 군사력을 강화하는 데 중요한 역할을 하고 있습니다. 이를 통해 정부는 전략적 목표를 추진하고 국가 이익을 보호하며, AI 기술에 대한 통제 권한을 유지할 수 있습니다.
국가 문화·언어 및 국가 고유 특성 보존
안보 측면뿐만 아니라 소버린 AI는 각 국가의 문화와 언어, 그리고 고유한 사회적 특성을 보존하는 데에도 기여합니다. 국내 데이터를 기반으로 개발된 AI 모델은 자국 언어와 사회적 맥락을 더 깊이 이해할 수 있으며, 이는 글로벌 AI 플랫폼에 대한 의존도를 줄이는 데 도움이 됩니다.
현재 많은 AI 모델은 서구 중심 데이터셋(Western-centric datasets)을 기반으로 학습되고 있기 때문에, 특정 문화적 편향을 반영하거나 지역적 맥락, 현지 언어 및 문화적 뉘앙스를 충분히 이해하지 못할 수 있습니다. 이러한 맥락에서 소버린 AI는 각 국가와 지역이 자국의 특성에 맞는 AI 시스템을 개발할 수 있도록 하며, 자국의 언어, 문화, 가치, 사회적 맥락을 보다 깊이 이해하는 데 기여합니다.
이는 글로벌 AI 학습 데이터에서 충분히 대표되지 않은 언어를 사용하는 국가들에게 특히 중요합니다. 예를 들어, 베트남 전용 독립 AI 모델은 베트남어 데이터를 기반으로 학습하여 베트남 문화적 참조를 이해하고, 베트남 사회의 기준에 맞는 적절한 반응을 제공할 수 있습니다. 이러한 능력은 글로벌 AI 모델이 제공하지 못할 수 있는 부분입니다.
경쟁력 강화 및 경제 성장 촉진
국가가 AI 기술을 자율적으로 개발하고 활용할 수 있다면 금융, 국방, 의료, 디지털 정부 등 전략 산업에서 기술 방향을 주도적으로 설정할 수 있습니다.
소버린 AI는 경제를 활성화하는 중요한 도구로 자리 잡고 있습니다. 언어, 문화, 법적 규제를 반영한 맞춤형·현지화된 AI 서비스를 개발함으로써, 국가들은 경쟁 우위를 확보하고 새로운 시장을 개척할 수 있습니다.
또한 이는 AI 스타트업부터 전통적인 ICT 기업의 AI 전환까지 국내 기술 기업의 성장을 돕고, GPUaaS나 데이터 센터와 같은 인프라 및 컴퓨팅 서비스에 대한 투자를 촉진하여 국가의 기술 역량을 강화합니다. 아울러 소버린 AI는 데이터 주권을 보호하고 해외 공급자에 대한 의존도를 줄이며, 국내 데이터를 안전하게 활용할 수 있도록 합니다. 성공적으로 소버린 AI를 개발한 국가는 국제 시장으로의 진출, 즉 문화적 수요가 유사한 지역에 AI 기술을 수출하는 것도 가능하게 됩니다. 이처럼 AI는 단순한 지원 도구를 넘어 전략적 자산으로 자리매김하며, 자율적이고 창의적이며 지속 가능한 경제를 구축하는 데 기여합니다.
법규 준수 및 시민 권리 보호
각 국가는 자국의 법률과 정책에 맞춘 AI 관리 및 규제 체계를 구축할 수 있습니다. 이를 통해 시민의 권리가 보호되고, 사회 전반에서 AI 기술에 대한 신뢰가 향상됩니다. 주권형 AI는 단순히 기술적 독립의 문제가 아니라, 법적·윤리적 책임을 다하는 AI 생태계를 구축하는 기반이 됩니다. 이를 통해 개인정보 유출 위험이나 민감한 데이터가 외국 기관에 의해 악용되는 것을 방지하며, 해당 데이터에 대한 접근과 사용 권한은 전적으로 국가 법률에 의해 조정되고 통제됩니다.
주권형 인공지능 개발은 다각적이고 지속적인 노력이 필요하며, 여러 핵심 분야에서 협력과 조율이 필수적입니다. 일반적으로, 국가들이 자국의 주권형 AI 역량을 구축할 때 따라야 할 여섯 가지 전략적 축은 디지털 인프라, 인력 개발, 연구·개발·혁신(RDI), 법적·윤리적 프레임워크, AI 산업 촉진, 국제 협력입니다.
소버린 AI 개발을 위한 전략 로드맵
디지털 인프라 주권형 AI의 근간은 강력한 디지털 인프라에 있습니다. 여기에는 방대한 데이터를 효율적으로 처리하고 분석할 수 있는 첨단 컴퓨팅 능력을 갖춘 현대적 데이터 센터가 포함됩니다. 또한, 데이터 주권과 보안을 강화하기 위해 국가 경계 내에서 생성된 데이터가 로컬에서 저장 및 처리되도록 하는 데이터 로컬리제이션 정책도 중요합니다. 이러한 인프라는 AI 기술의 개발과 활용을 위한 기반 역할을 합니다.
인력 개발 숙련된 인력은 AI 기술 발전의 핵심 요소입니다. 국가들은 STEM 교육을 강화하고, 학생과 전문가들이 AI 분야에서 경력을 쌓도록 장려해야 합니다. 이를 위해 모든 교육 단계에서 AI와 머신러닝 관련 커리큘럼을 업데이트하고, 직업 훈련 프로그램을 제공하며, 평생 학습 기회를 마련해야 합니다. 인력에 대한 투자로 국가들은 AI 산업을 선도할 수 있는 충분한 인재를 확보하고, 혁신을 촉진할 수 있습니다.
연구, 개발 및 혁신(RDI) AI의 가능성을 극대화하기 위해 연구·개발·혁신(RDI)에 대한 투자는 필수적입니다. 정부는 AI 연구를 위한 재정 지원과 인센티브를 제공하고, 기초 연구, 응용 연구 및 혁신의 상업화를 모두 지원해야 합니다.
또한, 스타트업, 기존 기업, 학술 및 연구 기관, 정부·비정부 기관, 투자자를 포함한 다양한 주체 간의 상생적 혁신 생태계를 구축해야 합니다. 이러한 오픈 이노베이션 네트워크는 협력, 파트너십, 투자를 촉진하며, 궁극적으로 국가가 글로벌 AI 분야에서 도약할 수 있는 혁신적 성과를 만들어냅니다.
법적·윤리적 프레임워크 혁신과 윤리적·규제적 고려 사이의 균형을 유지하는 것이 매우 중요합니다. AI 개발과 활용을 위한 명확한 가이드라인을 수립하고, 개인정보 보호, 투명성, 데이터 보안, 사이버 보안, 윤리적 사용과 같은 문제를 중점적으로 다루는 포괄적 법적·윤리적 프레임워크를 마련해야 합니다. 또한, 감독 및 책임 체계도 포함되어야 하며, AI 기술이 사회적 이익을 위해 책임감 있게 활용되도록 해야 합니다.
현재, 베트남은 2025년 12월 10일에 인공지능법을 통과시켰으며, 2026년 3월 1일부터 발효됩니다. 이 법은 베트남에서 처음으로 제정된 포괄적인 AI 관련 법적 틀로, 연구, 개발, 제공, 배포 및 AI 시스템 사용과 관련된 모든 활동에 적용됩니다. 법은 안전하고 투명하며 책임 있는 AI 개발을 지향하며, 인간의 이익을 우선으로 하고, 동시에 데이터 인프라와 국가 AI 역량 강화를 목표로 합니다.
한국은 “AI 기본법”(AI Basic Act, 또는 신뢰 구축 및 인공지능 개발에 관한 법률)을 제정하였으며, 2026년 1월 22일부터 시행됩니다. 이 법은 AI 개발, 위험 관리, 투명성 확보, “고위험” AI 시스템에서 인간의 책임 확보에 관한 규정을 제시하며, 국내외 기업이 안전 조치를 준수하고 AI 생성 콘텐츠에 라벨을 부착하며 국가 AI 관리 기관을 설립하도록 요구합니다.
AI 산업 촉진 AI 기반 기업과 애플리케이션의 성장을 지원하는 환경을 조성하는 것이 중요합니다. 특히 에너지, 의료, 금융, 교통, 제조 등 핵심 산업에서 이를 촉진해야 합니다. 정부의 세제 혜택, 보조금, 간소화된 특허 절차 등 정책적 인센티브는 AI 분야의 혁신과 창업 정신을 장려할 수 있습니다. 또한, 공공 부문의 AI 기술 도입은 효율성과 혁신의 모범 사례를 제공하며, 민관 협력 모델을 통해 AI 솔루션 개발과 적용을 가속화하고 사회적 문제를 해결하며 경제 성장을 촉진할 수 있습니다.
국제 협력 주권형 AI 개발이 국가 내 역량 활용에 초점을 두더라도, 국제 협력은 여전히 중요한 역할을 합니다. 다른 국가와의 대화와 협력을 통해 AI 관련 경험과 기술을 공유하고, 모범 사례를 학습하며, 정보 보안과 사이버 보안 등 공동 과제를 함께 논의할 수 있습니다. 또한, 국제 프로젝트 협력을 통해 자원과 전문 지식을 결집하여 기술 개발 속도를 높이고, 공동의 이익을 위한 AI 혁신을 촉진할 수 있습니다.
소버린 AI 구축의 과제
소버린 AI가 제공하는 이점은 매우 매력적이지만, 이를 구축하는 과정에서 조직과 국가들은 여러 가지 도전에 직면하게 됩니다. 이러한 장애 요소를 정확히 이해하는 것은 현실적인 전략을 수립하고 성공적으로 구현하기 위한 필수 조건입니다.
소버린 AI 구축의 과제
인프라 및 컴퓨팅 요구사항
독립적인 AI 역량을 구축하기 위해서는 상당한 수준의 인프라 투자가 필요합니다. 특히 대규모 언어 모델(LLM)을 학습하기 위해서는 수천 개의 고성능 GPU가 수주 또는 수개월 동안 지속적으로 작동해야 할 정도의 막대한 컴퓨팅 자원이 요구됩니다. 이러한 인프라를 구축하는 데에는 많은 조직이 부담을 느낄 수 있는 대규모 초기 투자 비용이 필요합니다.
또한 인프라 구축의 어려움은 단순히 하드웨어를 구매하는 것에서 끝나지 않습니다. 조직은 안정적인 전력 공급, 냉각 시스템, 네트워크 인프라, 데이터센터의 물리적 보안까지 함께 구축해야 합니다. 더 나아가 컴퓨팅 수요가 증가하고 기술이 발전함에 따라 인프라를 지속적으로 유지·관리하고 업그레이드해야 합니다.
특히 규모가 작은 국가나 조직의 경우 소버린 AI 구축에 필요한 인프라 투자 규모가 매우 부담스럽게 느껴질 수 있습니다. 그러나 최근 AI 하드웨어의 효율성이 향상되고, 모델 공유나 지역 기반 AI 협력과 같은 대안적 접근 방식이 등장하면서 이러한 비용 부담은 점차 완화되는 추세입니다.
기술 전문성 및 인재 확보
기술적인 측면에서, 주권형 AI 시스템은 데이터를 국경 밖으로 이동시키지 않기 위해 분산 학습과 같은 기법을 적용해야 하지만, 이는 모델 동기화, 정보 보안, 계산 효율성 측면에서 여러 가지 도전을 야기합니다. 또한, 최신 AI 모델을 기업이나 정부 기관의 기존 인프라에 통합하는 것도 어렵고, 결정 과정의 설명 가능성 및 모델 검증 요구 사항이 구현의 복잡성을 더욱 높입니다.
게다가, 독립적인 AI 시스템을 개발하려면 머신러닝 엔지니어링, 데이터 과학, AI 인프라 관리, 사이버 보안, 도메인 전문 지식 등 여러 분야에 걸친 깊은 기술 전문성이 필요합니다. 하지만 많은 조직과 국가들은 이러한 전문가가 심각하게 부족한 상황에 직면해 있습니다.
또한, 국내 AI 인재를 교육하고 양성하는 과정은 상당한 시간이 소요됩니다. 이러한 교육과 훈련 프로그램은 일반적으로 수년에 걸쳐 진행되므로, AI 전략을 시작하는 시점과 충분한 전문가를 확보하는 시점 사이에 시간적 격차가 발생할 수 있습니다.
전 세계적으로 AI 인재를 확보하기 위한 경쟁은 매우 치열합니다. 대형 기술 기업들은 높은 수준의 보상 패키지를 제공하고 있어, 정부 기관이나 중소규모 조직이 이를 경쟁하기는 쉽지 않습니다.
현재, AI 인력 부족 문제를 해결하기 위해 한국과 베트남은 다음과 같은 구체적인 조치를 시행하고 있습니다.
한국에서는 정부가 인공지능(AI) 인력 양성을 위해 대규모 정책을 적극적으로 추진하고 있다. 대표적인 정책으로는 약 1조 4천억 원을 투자하여 AI 교육을 초등·중등 교육부터 대학까지 전반적으로 확대하고, 학사–석사–박사 통합과정을 약 5.5년 내에 이수할 수 있도록 설계한 ‘AI 인재 양성 계획(AI Talent Development Plan)’이 있습니다. 이를 통해 고급 AI 인재 양성 기간을 단축하고자 합니다.
현재 베트남 정부는 AI 인재 부족 문제를 해결하기 위해 다양한 정책과 구체적인 프로그램을 추진하고 있다. 대표적으로 National Innovation Center(NIC)는 기업과 협력하여 ‘AI for All’ 프로그램을 운영하고 있으며, 이를 통해 전 국민을 대상으로 기초적인 AI 교육을 제공하여 디지털 역량과 인식 제고를 도모하고 있습니다.
현재 소버린 AI 구축은 글로벌 빅테크 기업들과의 ‘비대칭적 자원 전쟁’에 직면해 있습니다. 가장 큰 도전 과제는 천문학적인 투자 비용으로, 최신 파운데이션 모델 개발에는 주로 컴퓨팅 자원(GPU)과 전력 비용을 포함해 1억 달러 이상의 비용이 소요됩니다. 반면, 빅테크 기업들은 전 세계적인 데이터센터 인프라, 방대한 독점 데이터, 그리고 핵심 인재를 끌어들이는 강력한 네트워크 효과를 통해 압도적인 우위를 점하고 있습니다.
이러한 상황은 막대한 경제적 압박을 야기하며, 기업과 공공기관이 즉시 사용 가능하고 저렴한 외산 솔루션을 선택하게 함으로써 국산 모델이 존재하더라도 장기적인 기술적 종속(lock-in)이 고착화될 위험이 있습니다. 나아가, 이 경쟁은 개별 모델의 성능을 넘어 인프라, 클라우드, 반도체 및 보안을 아우르는 전체 생태계를 장악하려는 ‘AI 풀스택 전쟁’으로 확대되고 있어, 기술 주권을 보호하기 위한 정책적 인센티브가 절실히 요구됩니다.
글로벌 관점에서 본 소버린 AI
IBM Institute for Business Value(IBV)의 연구에 따르면, 조사에 참여한 경영진의 약 79%가 2030년까지 AI가 기업 매출에 긍정적인 영향을 미칠 것이라고 전망했습니다. 이러한 빠른 도입은 AI 인프라에 대한 새로운 의존성을 만들어내며, 동시에 통제, 규제 준수, 그리고 경쟁력과 관련된 다양한 과제를 제기하고 있습니다. 그리고 보고서에 따르면, AI는 두 단계로 뚜렷한 변화를 보인다고 할 수 있습니다.
2025년 이전에는 AI가 주로 효율성 향상과 자동화를 위한 도구로 활용되었으며, 비용 절감과 생산성 개선에 초점이 맞춰진 ‘AI 활용(AI-enabled)’ 단계에 해당한다고 볼 수 있습니다.
반면, 2025년 이후에는 AI-first 단계로 전환되며, AI는 단순한 보조 도구를 넘어 비즈니스 모델 자체를 정의하는 핵심 요소로 자리 잡게 됩니다. 특히 AI 투자는 효율성 중심에서 혁신 중심으로 이동하며, 새로운 제품과 가치를 창출하는 주요 동력으로 작용할 것으로 전망됩니다.
이와 같은 흐름 속에서 Sovereign AI는 중요한 트렌드로 부상하고 있습니다. 범용 AI 모델만으로는 경쟁 우위를 확보하기 어려워지면서, 각 국가와 기업의 데이터, 문화, 운영 방식에 최적화된 맞춤형 AI가 핵심 경쟁력으로 작용하게 됩니다.
따라서 2025년 이전에는 AI가 ‘효율화 도구’로 기능하였다면, 이후에는 ‘기업을 정의하는 핵심 기반’으로 발전하며, Sovereign AI는 지속 가능한 경쟁 우위를 확보하기 위한 중요한 전략으로 자리 잡는다고 할 수 있습니다.
유럽
유럽지역은 2024년부터 2028년까지 유럽 AI 시장의 연평균 성장률(CAGR)은 약 22.8%로 예상됩니다. 특히 데이터 솔루션과 클라우드 컴퓨팅 분야에 대한 투자가 증가하면서 AI 기술의 적용과 발전이 가속화되고 있습니다
여러 지역 가운데 유럽은 “ 소버린 AI”라는 개념을 가장 명확하게 사용하는 지역으로 평가됩니다. 이는 데이터, 디지털 인프라, 플랫폼, 기술 표준에 대한 자율성을 강조하는 “디지털 소버린티(Digital Sovereignty)” 전통과 밀접하게 연결되어 있으며, EU 차원의 강력한 규제 중심 거버넌스 모델과도 맞닿아 있습니다.
이러한 맥락에서 소버린 AI 는 단순한 국가 안보 문제를 넘어, EU 시민의 데이터, 클라우드 인프라, 그리고 글로벌 빅테크 기업에 의존하지 않는 독자적인 대규모 AI 모델 개발 역량을 확보하려는 전략적 자율성을 의미합니다.
특히 주목할 점은 EU가 개인정보 보호와 기술 경쟁력 사이의 균형을 재조정하려 하고 있다는 점입니다. 2025년에 제안된 Digital Omnibus 패키지는 AI 모델의 학습 및 배포 과정에서 개인 데이터를 보다 명확한 법적 틀 안에서 활용할 수 있도록 일부 GDPR 규정을 완화하는 방안을 포함하고 있습니다. 동시에 EU는 데이터 주권이라는 핵심 목표는 그대로 유지하고 있습니다.
또한 EU는 300억 달러 규모의 투자를 통해 대규모 AI 데이터 센터 네트워크를 구축하고 있습니다. 초기 13개 센터에는 100억 유로가 배정되었고, 향후 확장을 위해 200억 유로가 추가로 지원될 예정이며, 16개 회원국의 60여 개 지역에 설치될 계획입니다. 이 센터들은 수십만 개의 최첨단 GPU를 보유하여 EU가 대규모 AI 모델을 독립적으로 학습·운영하고, 외부 공급업체 의존도를 줄이며 AI 주권 역량을 강화할 수 있도록 합니다.
이러한 조치는 EU가 강력한 법적 틀을 구축하는 동시에, 소버린 AI를 실질적으로 구현할 수 있는 기술적·물리적 기반을 마련하고 있음을 보여줍니다.
미주
미주 지역에서는 소버린 AI 논의의 핵심이 기술 및 시장 경쟁력 유지에 있습니다. 캐나다의 경우 CAGR은 약 18.7%로 추정되며, 전체 AI 투자 점유율은 여전히 세계 최고 수준을 기록하고 있습니다. 이 지역에서는 자율주행, 헬스케어, 금융 등 다양한 산업 분야에서 AI 도입이 활발하게 이루어지고 있습니다.
특히 기초 모델(Foundation Models), 초대형 클라우드 인프라(Hyperscale Cloud), GPU 및 반도체 공급망에서의 우위를 유지하는 것이 중요한 전략으로 자리 잡고 있습니다.
동시에 AI의 위험을 관리하기 위해 2023년 미국의 AI 행정명령(Executive Order on AI), NIST AI Risk Management Framework, 그리고 FTC, FCC, SEC 등 규제 기관의 규정과 판례, 각 주(State) 차원의 AI 관련 법률이 함께 작동하고 있습니다. 이러한 규제는 특히 생성형 AI, 딥페이크, 채용·신용 평가·의료 분야에서의 AI 활용에 집중되고 있습니다.
이러한 접근 방식은 EU처럼 단일한 강력한 연방 차원의 규제로 AI를 통제하기보다는, 시장 경쟁력과 기술 혁신을 기반으로 한 ‘시장 중심형 소버린 AI’ 모델로 볼 수 있습니다.
한편 캐나다와 브라질, 멕시코 등 일부 라틴아메리카 국가에서는 OECD의 AI 원칙(투명성, 공정성, 안전성, 책임성)을 기반으로 AI 법안 및 국가 전략을 수립하거나 추진 중입니다. 이는 해외 플랫폼에 대한 과도한 의존을 줄이고 AI를 활용해 생산성 향상과 포용적 성장을 도모하기 위한 것입니다.
다만 EU에 비해 소버린 AI의 제도화 수준은 아직 낮은 편입니다. 법제화가 진행 중인 단계이며, 컴퓨팅 인프라와 데이터 생태계는 여전히 글로벌 기술 기업에 대한 의존도가 높습니다. 따라서 많은 국가들이 독자적인 소버린티 모델을 구축하기보다는 국제 표준과 규범에 맞춰 발전하는 전략을 선택하는 경향을 보입니다.
아시아-태평양
아시아-태평양(APAC) 지역은 2024년부터 2028년까지 APAC 지역 AI 시장의 예상 CAGR은 약 29.6%입니다. 중국, 인도, 일본, 한국 등 주요 국가에서 디지털화와 AI 도입 속도가 빠르게 진행되고 있으며, 스마트 제조, 모빌리티, 금융, 헬스케어 등 다양한 분야에서 AI 솔루션의 활용이 확대되고 있습니다. 일부 국가는 데이터와 콘텐츠에 대한 강력한 규제를 강조하는 반면, 다른 국가는 혁신과 실험을 우선하는 정책을 채택하고 있습니다.
많은 국가들이 소버린 AI를 데이터 보안, 사이버 보안, 그리고 전략적 기술 자립의 관점에서 바라보고 있습니다.
이 스펙트럼의 한쪽 극단에는 중국이 있습니다. 중국은 알고리즘, 생성형 AI, 그리고 국경 간 데이터 이동에 대한 세부적인 규제 체계를 구축하고 있습니다. 이러한 규제는 콘텐츠 관리, 전략적 데이터의 국내 보관, 그리고 클라우드·AI·반도체 생태계에서의 국내 기업 우선 정책을 중심으로 운영됩니다.
이는 데이터, 컴퓨팅, 모델, 애플리케이션, 콘텐츠 유통까지 AI 가치 사슬 전반을 강하게 규제하는 국가 중심형 소버린 AI 모델을 형성합니다.
반면 일본과 호주는 보다 완화된 접근 방식을 취하고 있습니다. 이들 국가는 정책 가이드라인과 지원 정책을 통해 자국 내 Foundation Model 개발을 촉진하는 데 초점을 맞추고 있습니다.
목표는 “신뢰할 수 있으면서도 혁신 친화적인” AI 생태계를 구축하는 것입니다. 즉, 사회적 신뢰를 확보하면서도 투자와 인재 유입을 촉진하여 유연한 형태의 ‘소프트 소버린 AI’를 달성하려는 전략입니다.
한국
HyperCLOVA
2019년부터 2023년까지 한국 AI 시장의 CAGR은 약 21.2%로 한국은 APAC 지역에서 특히 독특한 접근 방식을 취한 사례로 평가됩니다. 한국은 AI 기본법(Basic Act on AI, AI Framework Act)이라는 단일 법률 프레임워크를 통해 AI 전략, 산업 육성 정책, 그리고 위험 규제 체계를 하나의 법률 안에 통합하려는 접근을 선택했습니다.
이 법안은 2024년 말 국회를 통과했으며, AI 분야에서의 국가 경쟁력을 강화하는 동시에 윤리 기준과 국민 신뢰를 확보하는 것을 목표로 합니다. 이를 통해 글로벌 AI 경쟁 속에서 국가 기술 주권을 강화하려는 전략적 의도가 담겨 있습니다.
소버린 AI 측면에서 한국은 “AI G3”, 즉 세계 3대 AI 강국 중 하나가 되는 것을 목표로 하고 있습니다. 이를 위해 공공-민간 협력 정책을 통해 국내 기업의 기초 모델, AI 반도체, 글로벌 AI 서비스 개발을 적극 지원하고 있습니다. 동시에 한국은 GPAI, OECD, 글로벌 AI 서밋 등 다자 협력 플랫폼에도 적극 참여하며 국제 AI 거버넌스 논의에 기여하고 있습니다.
현재 한국에서는 네이버 클라우드(NAVER Cloud)가 AI 분야에서 두드러진 존재감으로 자리 잡고 있습니다. 네이버 클라우드는 국가 데이터와 자국 인프라를 기반으로 문화와 국가적 가치를 깊이 이해하는 모델을 개발함으로써 소버린 AI를 촉진하고 있습니다. HyperCLOVA X 모델부터 슈퍼컴퓨터와 차세대 데이터 센터에 이르는 AI 전체 가치 사슬에서의 종합적인 역량을 바탕으로, 네이버는 국가들이 기술 자율성을 확보할 수 있도록 돕는 엔에이블러(enabler) 역할을 수행하고 있습니다.
소버린 AI에 대한 자주 묻는 질문?
소버린 AI란 무엇입니까?
소버린 AI는 국가, 조직 또는 기업이 자신의 AI 시스템, 데이터, 그리고 기술 인프라를 독립적으로 통제하고 개발하며 관리할 수 있는 능력을 의미합니다. 이를 통해 데이터와 알고리즘, 그리고 AI의 의사결정 과정이 외부 플랫폼에 의존하지 않고 자국의 법률, 문화적 가치, 전략적 이익에 맞게 운영되도록 보장할 수 있습니다.
왜 소버린 AI 중요합니까?
소버린 AI 중요한 이유는 인공지능이 디지털 경제의 핵심 기반 기술로 자리 잡고 있기 때문입니다. AI를 자율적으로 관리하면 데이터 주권을 보호하고 기술 보안을 강화하며 혁신을 촉진할 수 있습니다. 또한 해외 기술 기업에 대한 의존도를 줄이고, AI 시스템이 각 국가의 법적 규제와 윤리 기준에 맞게 개발·운영되도록 보장할 수 있습니다.
소버린 AI를 구축할 때 어떤 어려움이 있습니까?
소버린 AI를 구축하는 과정에는 여러 가지 도전 과제가 존재합니다. 국가와 기업은 대규모 데이터, 강력한 컴퓨팅 인프라, 그리고 높은 수준의 AI 전문 인력을 확보해야 합니다. 또한 인프라 구축에 필요한 높은 투자 비용, 데이터 거버넌스 문제, 그리고 보안·혁신·국제 협력 간의 균형을 유지하는 것 역시 중요한 과제입니다.
마무리
소버린 AI는 고품질 로컬 데이터와 전문적인 라벨링 데이터를 기반으로 구축될 때 그 진가를 발휘합니다. 이를 통해 현지 맥락을 정확히 반영하고 데이터 주권 요구사항을 충족하는 AI 솔루션을 개발할 수 있습니다.
LTS Group은 다양한 AI 프로젝트 경험과 전문성을 바탕으로, 데이터 수집과 전처리, 머신러닝 모델 구축, 그리고 실제 비즈니스 시스템 통합까지 종합적인 AI 역량을 제공합니다. 빅데이터 처리, 컴퓨터 비전, 자연어 처리(NLP), 생성형 AI 등 첨단 기술을 활용하여 기업이 데이터 주권을 강화하고 AI를 전략적으로 운용할 수 있도록 지원합니다.
이러한 역량은 LTS Group이 지역과 글로벌 시장에서 신뢰할 수 있는 AI 솔루션을 선도할 수 있는 기반이 되며, AI 주권이 점점 더 중요한 전략적 우선순위로 부상하는 흐름에 부합합니다.
Share
내용의 테이블
Table of Contents
유미 도
한국 시장의 IT 분야에 대한 콘텐츠 제작자인 유미를 만납시다 그분은 정보기술 분야에 깊게 관심을 갖고 특히 신규 기술 분야에서 한국과 베트남 협력관계 및 IT 솔루션에 대한 정보를 독자들에게 신속하게 전할 수 있습니다. 유익한 IT 지식으로 독자와 함께 친한 친구가 되고 재미있는 기술여정 완전히 즐길 수 있음을 믿습니다. TrangTH@ltsgroup.tech 이메일로 연락하세요.
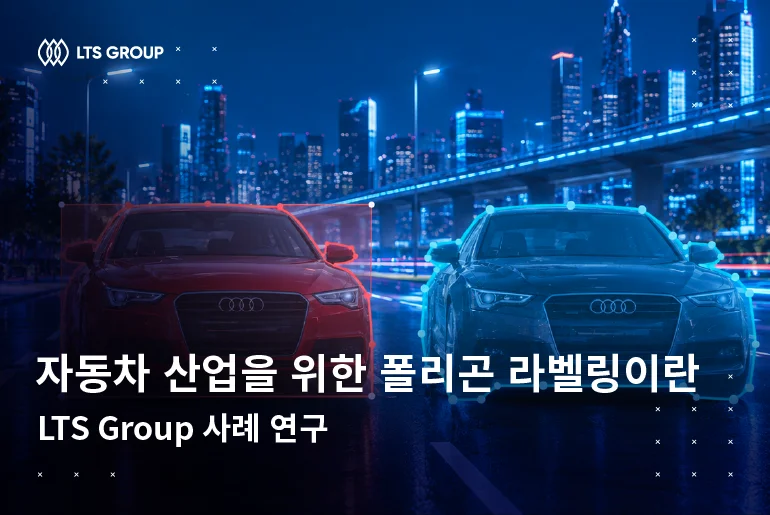
차량이 고속도로를 주행하다 차선이 점차 희미해지는 구간에 진입했다고 가정해 보겠습니다. 포장이 일부 벗겨진 노면 위로 빗물이 고여 있고, 전방에서는 두 개의 차선이 하나로 합류하며, 공사 구간을 알리는 라바콘이 기존 차선 위에 비스듬히 놓여 있습니다. 이 상황에서 ADAS 시스템이 차선 유지 기능을 정상적으로 수행하려면, 차량은 직선도 사각형도 아닌 이 복잡한 경계를 실제 형태 그대로 인식할 수 있어야 합니다.
이처럼 현실의 도로 환경은 좀처럼 반듯한 형태를 허락하지 않습니다. 그리고 바로 이 지점에서 폴리곤 라벨링이 필요해집니다. 폴리곤 라벨링은 객체의 가장자리를 따라 다수의 꼭짓점을 배치해 실제 윤곽을 픽셀 단위로 포착하는 어노테이션 기법으로, 직사각형으로는 담아낼 수 없는 형태 정보를 AI 모델에 전달하는 역할을 합니다. 자율주행 및 ADAS 개발에서 폴리곤 라벨링이 꾸준히 선택되는 이유도 여기에 있습니다.
이번 글에서는 다음과 같은 내용을 차례로 살펴봅니다.
폴리곤 라벨링이란 무엇인가
폴리곤 라벨링의 주요 이점
폴리곤 라벨링 작동 방식
자동차 산업에서의 활용 사례
전문 데이터 솔루션 파트너가 필요한 이유: LTS Group 사례 연구
Table of Contents
Toggle
폴리곤 라벨링이란?주행 장면에서 폴리곤과 바운딩 박스 비교수동, 자동, 하이브리드 접근법 비교자동차 및 자율주행 분야에서의 중요 역할폴리곤 라벨링의 주요 이점불규칙한 도로 객체에 대한 픽셀 단위 정확도배경 잡음 감소 및 모델 정확도 향상다양한 객체 클래스 및 조건에 대한 유연성데이터 증강과의 높은 호환성폴리곤 라벨링 작동 방식 – LTS Group의 작업 흐름데이터셋 준비 및 클래스 정의폴리곤 그리기 및 라벨링다단계 품질 관리데이터 내보내기 및 파이프라인 통합자동차 산업에서의 폴리곤 라벨링 활용 사례차선 및 주행 가능 영역 탐지도로 표지판 및 교통 인프라 인식취약한 도로 사용자 분할장애물 및 극한 케이스 처리왜 폴리곤 어 라벨링을 위해 전문 데이터 솔루션 파트너를 선택해야 하는가? – LTS Group 사례 연구차선 검출을 위한 폴리곤 라벨링자주 묻는 질문결론
폴리곤 라벨링이란?
폴리곤 라벨링은 이미지 내 객체 주위에 여러 점으로 이루어진 다각형을 그려서 그 객체의 정확한 경계와 외곽을 포착하는 작업을 말합니다. 폴리곤은 점의 개수에 제한이 없어 객체의 실제 형태에 더 밀착해서 맞출 수 있습니다. 이는 두 개의 코너 점으로 정의되는 간단한 직사각형인 바운딩 박스와는 대조적입니다. 이러한 세밀한 라벨링은 특히 불규칙한 형태를 가진 객체를 더 정확하게 표현할 수 있게 해줍니다.
폴리곤 라벨링은 객체 탐지, 인스턴스 분할, 의미론적 분할과 같은 작업의 기초가 됩니다. 이는 머신러닝 모델에 객체의 형태, 크기, 위치에 관한 세밀한 정보를 제공하여 보다 정확한 예측과 분류를 가능하게 합니다. 예를 들어, 특히 YOLOv8 폴리곤 라벨링과 같은 고급 버전은 불필요한 픽셀을 줄여 객체 탐지 성능을 향상시키기 위해 폴리곤을 활용합니다.
주행 장면에서 폴리곤과 바운딩 박스 비교
자동차, AI, 컴퓨터 비전 분야에서 객체 위치 인식 및 분할 시 두 가지 주요 어노테이션 기법인 바운딩 박스와 폴리곤이 널리 사용됩니다. 아래 표는 두 기법의 주요 요소별 특성을 정리한 비교표입니다.
요소(Factor)
바운딩 박스 (Bounding Box)
폴리곤 (Polygon)
어노테이션 속도
높음
중간에서 낮음
복잡도
낮음
높음
비용 효율성
높음
낮음
경계 정밀도
보통
높음
대규모 데이터셋 처리
우수
더 까다로움
객체 탐지
우수
적합
분할(Segmentation)
제한적
우수
불규칙한 객체 처리
적합도 낮음
매우 적합
라벨링 속도 및 복잡도
바운딩 박스는 간단한 직사각형 형태로 두 점만 지정하면 되기 때문에 작업 속도가 빠르고 복잡도가 낮습니다. 반면, 폴리곤은 다각형 형태로 객체 모양을 상세히 그려야 하므로 속도가 느리고 작업이 복잡합니다.
비용 효율성
속도가 빠른 바운딩 박스는 작업시간과 인력 비용 면에서 효율적입니다. 폴리곤은 세밀한 작업이 필요하여 비용이 더 많이 들 수밖에 없습니다.
경계 정밀도
폴리곤 방식은 객체의 모양을 정확히 따라가 경계 정밀도가 높아 특히 불규칙하거나 복잡한 형태를 가진 객체에 유리합니다. 바운딩 박스는 단순 직사각형이므로 경계가 다소 부정확할 수 있습니다.
대규모 데이터셋 및 모델 적용
대규모 데이터를 빠르게 어노테이션해야 할 경우 바운딩 박스가 적합하며 확장성도 뛰어납니다. 폴리곤은 작업 난이도가 높아 대규모 데이터 처리 및 자동화가 요구될 때 부담으로 작용할 수 있습니다.
객체 탐지와 분할 효용 차이
객체 위치 탐지에서는 바운딩 박스가 뛰어나고 폴리곤은 적합한 편입니다. 반면, 세분화 작업(특히 인스턴스·시맨틱 세그멘테이션)에서는 폴리곤 방식이 훨씬 우수한 성능을 보입니다.
불규칙한 객체 처리
다양한 모양의 불규칙 객체 인식에 폴리곤이 월등히 적합합니다. 바운딩 박스는 단순한 사각형 형태로 불규칙한 경계 표현이 제한적입니다.
폴리곤 라벨링 도구
구분
주요 기능 및 설명
AI 보조 라벨링
– SAM 기반 도구: 긍정/부정 포인트 클릭으로 폴리곤 자동 생성
– Meta 연구 결과, 간단한 경우 5배 빠른 속도
– 현실적 보정 필요: 30~50% 마스크는 경계, 차폐, 클래스 모호성 때문에 보정 필수
수동 효율성 기능
– 자동 점 배치, 에지 스내핑, 폴리곤 스내핑 지원
– 단축키 제공: SPACE(폴리곤 닫기), SHIFT+클릭(점 삭제), CTRL+Z(실행 취소)
내보내기 포맷
– COCO JSON (인스턴스 분할 표준)
– YOLO 호환 포맷 (YOLOv5-seg, v7, v8 정규화 좌표)
– RLE 인코딩 (밀집 마스크 대체 방식)
수동, 자동, 하이브리드 접근법 비교
라벨링 워크플로는 사용 가능한 자원, 일정, 데이터셋 복잡도에 따라 달라집니다. 아래는 세 가지 주요 접근법에 대한 개요입니다.
접근법
작동 방식
장점
단점
최적 활용 상황
매뉴얼 라벨링
데이터셋 내 모든 객체에 대해 사람이 폴리곤을 직접 그림
높은 정확도, 소규모 데이터셋에 적합
노동 집약적이고 시간 소요 큼
작은 데이터셋이나 높은 정밀도가 필요한 경우
자동화 라벨링
알고리즘이 객체를 자동으로 탐지하고 어노테이션 수행
대규모 데이터셋에 대해 빠른 처리 가능
정확도 검증을 위한 수동 검토 필요
대규모 데이터셋이나 반복 작업에 적합
하이브리드 접근법
자동 어노테이션 후 사람이 직접 수정 및 보완
높은 정확도와 효율성을 동시에 달성 가능
작업 프로세스가 다소 복잡할 수 있음
복잡하고 대규모 데이터셋에 적합
자동차 및 자율주행 분야에서의 중요 역할
고급 ADAS 및 고도 자율주행 차량에서는 차량이 실시간으로 수많은 복잡한 상황을 처리해야 합니다. 이 과정에서 폴리곤 라벨링은 다음과 같은 핵심적인 역할을 수행합니다.
복잡한 형태의 정확한 인식
기존의 바운딩 박스(bounding box) 방식은 불규칙한 형태의 물체를 감쌀 때 주변 배경이 포함되어 공간이 남는 경우가 많습니다. 반면 폴리곤 라벨링은 다음과 같은 대상의 크기, 각도, 경계를 정확하게 파악할 수 있도록 돕습니다.
다양한 자세의 보행자
부분적으로 가려졌거나 복잡한 각도를 가진 자동차, 오토바이, 자전거 등 교통 수단
교통 표지판, 차선(lane lines), 도로상의 장애물
시맨틱 세그멘테이션 최적화
자율주행 AI는 영상의 각 픽셀 단위로 도로, 인도, 장애물을 명확하게 구분할 필요가 있습니다. 다각형 라벨링으로 라벨링된 학습 데이터는 모델이 ‘픽셀 단위 정밀도’를 달성하는 데 크게 기여합니다.
주행 경로 및 안전 거리 계산 최적화
물체의 경계가 명확하게 정의됨으로써, 자율주행 차량은 안전 거리 및 주행 경로를 보다 정확히 산출할 수 있습니다. 이를 통해 신속한 제동 및 회피 동작 결정이 가능하며, 물체 크기 오인에 따른 오류를 최소화합니다.
폴리곤 라벨링의 주요 이점
폴리곤 라벨링은 다른 어노테이션 기법에 비해 작업 시간이 더 소요되지만, 자동차 산업에서 꾸준히 선택되는 데에는 분명한 이유가 있습니다. 아래에서는 자율주행 인지 모델 개발 관점에서 폴리곤 라벨링이 제공하는 네 가지 핵심 이점을 살펴보겠습니다.
불규칙한 도로 객체에 대한 픽셀 단위 정확도
실제 도로 환경에서 마주하는 객체는 좀처럼 반듯한 직사각형 형태를 띠지 않습니다. 비스듬히 주차된 차량, 적재물이 돌출된 트럭, 우산을 든 보행자, 곡선형 가드레일처럼 윤곽이 복잡한 대상이 대부분입니다. 폴리곤 라벨링은 객체의 가장자리를 따라 다수의 꼭짓점(vertex)을 배치하여 실제 외곽선을 그대로 따라가기 때문에, 바운딩 박스로는 포착할 수 없는 형태 정보를 픽셀 단위로 정밀하게 기록할 수 있습니다. 이러한 정밀도는 특히 근거리 판단에서 중요한 역할을 합니다. 차량이 객체와 가까워질수록 ‘어디에 있는가’보다 ‘어떤 형태로 공간을 점유하고 있는가’가 회피 경로 설계의 핵심 변수가 되기 때문입니다.
배경 잡음 감소 및 모델 정확도 향상
직사각형 바운딩 박스는 객체를 감싸는 과정에서 필연적으로 상당량의 배경 픽셀을 함께 포함하게 됩니다. 특히 자전거나 오토바이처럼 윤곽이 얇고 복잡한 객체의 경우, 박스 내부의 절반 이상이 도로 노면이나 다른 배경으로 채워지는 경우도 발생합니다. 이러한 불필요한 픽셀은 학습 과정에서 잡음(noise)으로 작용하여 모델의 판단력을 저하시킵니다. 반면 폴리곤은 객체 영역만을 정확히 분리해 데이터셋의 신호 대 잡음비(SNR)를 개선합니다. 실제로 2023년 발표된 연구에 따르면, 폴리곤으로 라벨링된 데이터셋으로 학습한 모델은 바운딩 박스 기반 데이터셋 대비 객체 세그멘테이션 작업에서 약 18% 높은 정확도를 기록한 것으로 나타났습니다.
다양한 객체 클래스 및 조건에 대한 유연성
폴리곤 라벨링의 또 다른 강점은 하나의 기법으로 매우 다양한 대상을 포괄할 수 있다는 점입니다. 교통 표지판과 신호등처럼 형태 자체가 의미를 지니는 객체부터, 차선 영역과 주행 가능 공간(free space)처럼 넓고 불규칙한 영역, 공사 구간이나 적재물 낙하와 같은 예외 상황(edge case)까지 동일한 방식으로 처리할 수 있습니다. 특히 혼잡한 교차로처럼 동일 클래스의 객체가 서로 겹쳐 있는 장면에서, 폴리곤은 인스턴스 세그멘테이션(instance segmentation)의 기반이 되어 차량 A와 차량 B를 명확히 구분해 줍니다. 바운딩 박스로는 서로 중첩되어 구분이 어려운 상황에서도 개별 객체의 경계를 유지할 수 있다는 점은 밀집 교통 환경 학습 데이터 구축에서 결정적인 차이를 만듭니다.
데이터 증강과의 높은 호환성
자율주행 학습 데이터는 제한된 원본 데이터로부터 최대한 다양한 상황을 학습시키기 위해 회전, 반전, 스케일 조정 등의 데이터 증강 기법을 폭넓게 활용합니다. 이때 축 정렬 방식의 바운딩 박스는 이미지를 회전시키면 객체와의 정합이 어긋나면서 불필요한 여백이 크게 늘어나는 구조적 한계를 지닙니다. 반면 폴리곤은 각 꼭짓점이 객체의 실제 윤곽을 따라 정의되어 있어, 변환 이후에도 객체에 밀착된 형태를 그대로 유지합니다. 결과적으로 증강된 데이터의 라벨 품질이 원본 수준으로 보존되며, 동일한 원본 데이터셋으로부터 더 많은 양의 신뢰할 수 있는 학습 데이터를 확보할 수 있습니다.
폴리곤 라벨링 작동 방식 – LTS Group의 작업 흐름
폴리곤 라벨링은 단일 작업이 아니라, 원본 주행 영상이 학습 가능한 데이터셋으로 전환되기까지의 구조화된 파이프라인입니다. 아래에서는 LTS Group이 실제 자동차 산업 프로젝트에서 수행하는 네 단계의 작업 흐름을 순서대로 살펴보겠습니다.
데이터셋 준비 및 클래스 정의
첫 번째 폴리곤을 그리기 전에, 저희 프로젝트 매니저는 고객사와 함께 어노테이션 온톨로지(ontology)를 확정합니다. 어떤 객체 클래스를 정의할 것인지, 각 클래스의 명칭을 어떻게 통일할 것인지, 그리고 한 클래스의 경계가 어디에서 끝나고 다른 클래스가 시작되는지를 명확히 규정하는 단계입니다. 이후 주행 영상 데이터를 가져와 관리 가능한 단위의 작업 배치(batch)로 분류하며, 야간 주행·우천·공사 구간과 같은 예외 상황(edge case) 데이터는 별도로 구분하여 숙련된 전담 인력이 처리하도록 배정합니다. 이러한 사전 표준화 작업은 데이터셋 실패의 가장 흔한 원인, 즉 두 명의 작업자가 동일한 객체를 서로 다르게 라벨링하는 문제를 근본적으로 차단하는 역할을 합니다.
폴리곤 그리기 및 라벨링
저희 어노테이터는 고객사가 지정한 플랫폼(CVAT, Supervisely 또는 SLA에 명시된 도구)을 활용해 각 객체의 외곽선을 따라 꼭짓점을 배치합니다. 데이터량이 많은 클래스에 대해서는 하이브리드 방식을 적용하는데, AI 기반 사전 라벨링(pre-labeling)으로 초안 폴리곤을 생성한 뒤 숙련된 작업자가 실제 객체 윤곽에 맞추어 정밀하게 보정하는 방식입니다. 모든 폴리곤에는 클래스 라벨이 부여되며, 프로젝트 요구사항에 따라 가림 정도(occlusion)나 절단 여부(truncation)와 같은 부가 속성도 함께 기록됩니다. 작업이 진행되는 동안 팀 리더가 작업량과 가이드라인 준수 여부를 지속적으로 모니터링하여, 기준 이탈이 발생할 경우 납품 시점이 아닌 작업 중에 즉시 교정합니다.
다단계 품질 관리
어노테이션이 완료된 배치는 고객사에 전달되기 전 계층적 검수 과정을 거칩니다. 1차 리뷰어가 꼭짓점 배치의 일관성, 클래스 정확도, 프로젝트별 세부 규칙 준수 여부를 점검하고, 이후 시니어 리뷰어가 검수된 결과물을 표본 추출하여 재감사(audit)합니다. 저희는 오류를 단순히 수정하는 데 그치지 않고, 해당 오류의 발생 원인을 작업자 단위까지 추적하여 맞춤형 재교육으로 연결합니다. 이러한 순환 구조가 100만 건 이상의 데이터 포인트 규모의 프로젝트에서도 99%의 정확도를 안정적으로 유지할 수 있었던 핵심 요인입니다.
데이터 내보내기 및 파이프라인 통합
최종 데이터셋은 고객사의 학습 파이프라인이 요구하는 형식(COCO, Pascal VOC, YOLO 또는 착수 단계에서 협의된 맞춤 스키마)으로 내보내집니다. 납품은 한 번에 일괄 전달하는 방식이 아니라 단계적으로 진행되므로, 고객사의 머신러닝 팀은 후속 배치가 작업 중인 상황에서도 먼저 전달받은 데이터로 모델 학습을 시작할 수 있습니다. 납품 이후에는 프로젝트 매니저가 피드백을 수집하여 다음 단계의 가이드라인에 반영하며, 이를 통해 프로젝트가 진행될수록 어노테이션 품질이 누적적으로 향상되는 구조를 구축합니다.
LTS Group에 대하여
LTS Group은 10년 이상 데이터 라벨링 분야에 전념해 온 전문 기업으로, 다수의 한국 완성차 및 자율주행 기술 기업과 장기간 협업하며 실질적인 노하우를 축적해 왔습니다. 저희의 강점은 단순한 인력 공급이 아니라, 프로젝트 규모 변화에 유연하게 대응하는 확장 역량에 있습니다. 실제 한국 고객사 프로젝트에서는 전문 인력 40명으로 초기 20만 장의 이미지를 완수한 뒤, 품질과 일정 기대치를 상회하는 성과를 바탕으로 팀 규모를 140명 이상으로 확대하여 1년 이내에 100만 건 이상의 데이터 포인트를 99% 정확도로 처리한 바 있습니다.
전담 프로젝트 매니저 배정, 파일럿 프로젝트를 통한 사전 검증, 그리고 다단계 품질보증 체계를 기반으로, 저희는 고객사가 요구하는 정확도 기준을 충족하는 동시에 개발 일정을 단축할 수 있도록 지원합니다. 자율주행 데이터 라벨링 파트너를 검토 중이시라면, LTS Group이 귀사의 신뢰할 수 있는 선택지가 될 수 있습니다.
자동차 산업에서의 폴리곤 라벨링 활용 사례
폴리곤 라벨링의 가치는 이론적 설명보다 실제 적용 사례에서 더욱 분명하게 드러납니다. 아래에서는 자율주행 및 ADAS 개발 현장에서 폴리곤 어노테이션이 어떤 방식으로 활용되고 있는지, 네 가지 대표적인 영역을 중심으로 살펴보겠습니다.
차선 및 주행 가능 영역 탐지
자율주행 시스템이 가장 먼저 판단해야 할 것은 ‘어디까지가 주행 가능한 공간인가’입니다. 차선 영역과 도로 경계, 그리고 주행 가능 영역(free space)은 직선으로 정의되는 경우가 거의 없으며, 곡선 구간이나 합류·분기 구간, 회전 교차로에서는 그 형태가 더욱 복잡해집니다. 폴리곤 라벨링은 이러한 영역의 실제 경계를 면(area) 단위로 정밀하게 포착하여, 모델이 노면·인도·갓길을 구분하고 안전하게 주행할 수 있는 공간을 판단하도록 학습시킵니다. 실무에서는 차선 중심선처럼 선형 요소를 다루는 폴리라인 어노테이션과 병행하여, 영역 정보와 경로 정보를 함께 구축하는 방식이 일반적으로 채택됩니다.
도로 표지판 및 교통 인프라 인식
교통 표지판은 형태 자체가 의미를 전달하는 대표적인 객체입니다. 원형, 삼각형, 역삼각형, 팔각형 등 표지판의 외형은 규제·주의·지시 등 표지의 성격을 구분하는 핵심 단서이기 때문에, 이를 직사각형으로 단순화하면 중요한 정보가 유실될 수 있습니다. 폴리곤 라벨링은 표지판의 실제 윤곽을 그대로 따라 그려 형태 정보를 온전히 보존하며, 신호등과 지주, 가드레일, 중앙분리대와 같은 교통 인프라 요소에도 동일하게 적용됩니다. 특히 표지판이 가로수나 다른 차량에 일부 가려진 상황에서, 폴리곤은 보이는 영역만을 정확히 분리해 학습 데이터의 신뢰도를 유지할 수 있도록 합니다.
취약한 도로 사용자 분할
보행자, 자전거 이용자, 이륜차 운전자와 같은 취약한 도로 이용자(VRU, Vulnerable Road Users)는 자율주행 안전성 평가에서 가장 높은 우선순위를 차지하는 대상입니다. 문제는 이들이 혼잡한 교차로나 횡단보도에서 서로 겹쳐 있는 경우가 빈번하다는 점입니다. 바운딩 박스를 적용하면 여러 보행자의 박스가 중첩되어 개별 객체를 구분하기 어려워지지만, 폴리곤은 각 인물의 실제 윤곽을 따라 경계를 유지하므로 인스턴스 세그멘테이션의 기반 데이터로 활용될 수 있습니다. 또한 자전거처럼 차체가 얇고 복잡한 객체의 경우 바운딩 박스 내부의 상당 부분이 배경으로 채워지는 반면, 폴리곤은 객체 영역만을 정확히 분리하여 학습 효율을 크게 높입니다.
장애물 및 극한 케이스 처리
실제 도로에서 발생하는 위험 상황은 정형화된 형태를 띠지 않습니다. 공사 구간의 라바콘과 임시 차단 시설, 이중 주차된 배송 차량, 노면에 떨어진 적재물, 침수 구간이나 결빙 구간처럼 경계가 모호한 영역이 대표적입니다. 이러한 극한 케이스(edge case)는 발생 빈도가 낮지만 사고로 이어질 가능성이 높아, ISO 21448(SOTIF)이 요구하는 안전성 검증에서 핵심적으로 다루어지는 대상이기도 합니다. 폴리곤 라벨링은 형태가 불규칙하고 사전에 정의하기 어려운 이러한 대상들을 유연하게 포착할 수 있어, 모델이 예외 상황에 대응하는 능력을 학습하는 데 가장 적합한 기법으로 평가됩니다.
왜 폴리곤 어 라벨링을 위해 전문 데이터 솔루션 파트너를 선택해야 하는가? – LTS Group 사례 연구
폴리곤 라벨링은 기술적으로 단순해 보이지만, 실제 프로젝트 규모로 확장되는 순간 전혀 다른 성격의 과제가 됩니다. 수십만 장의 이미지를 다루면서도 모든 작업자가 동일한 기준으로 꼭짓점을 배치해야 하고, 국가별로 다른 차선 표기 방식이나 야간·우천 환경의 흐릿한 경계처럼 판단이 엇갈리기 쉬운 상황에 일관된 규칙을 적용해야 합니다.
이러한 일관성은 도구의 성능이 아니라 프로세스 설계와 인력 운영 역량에서 비롯됩니다. 검증된 데이터 솔루션 파트너는 착수 전 가이드라인 정립과 파일럿 검증, 숙련된 어노테이터 선발 및 맞춤 교육, 동료 검수와 시니어 QA로 이어지는 다단계 품질 관리 체계, 그리고 프로젝트 규모 변화에 대응하는 인력 확장 역량을 하나의 통합된 워크플로우로 제공합니다.
완성차 업체와 ADAS 기술 기업이 내부 리소스만으로 이를 구축하려면 상당한 시간과 비용이 소요되는 반면, 전문 파트너와 협업할 경우 즉시 검증된 체계를 활용하면서 내부 엔지니어링 팀은 모델 개발이라는 핵심 과제에 역량을 집중할 수 있습니다.
차선 검출을 위한 폴리곤 라벨링
고객사 개요
고객사는 자율주행차 산업의 소프트웨어 개발을 위한 데이터 솔루션을 제공하는 대한민국 기업입니다. 이 회사는 글로벌 자동차 제조사 및 기술 제공업체들을 대상으로 첨단 운전자 지원 시스템(ADAS) 학습과 검증에 필요한 데이터 파이프라인을 지원하고 있습니다.
ADAS 시스템은 고품질의 라벨링된 데이터에 의존하며, 고객사는 여러 국가에서 촬영한 대규모 도로 장면 데이터셋을 처리할 신뢰할 수 있는 파트너가 필요했습니다. 이번 프로젝트의 주요 과제는 차선 주석(annotation)에 집중하는 것이었습니다. 이는 차선 이탈 경고, 차선 유지 및 자율 주행을 가능하게 하는 시스템 구성에 핵심적인 요소입니다.
고객 요구 사항
주석 범위: 2D 이미지 내 차선 객체를 식별하고 주석을 달아야 함
데이터 양: 고속도로, 도시 도로, 농촌도로 등 다양한 국가에서 수집된 16만 장 이상의 이미지
라벨링 유형: 곡선 및 불규칙한 차선 경계선을 정확하게 포착할 수 있는 다각형(폴리곤) 라벨링
프로젝트 목적: 다양한 도로 상황에서 정확한 차선 경계 인식을 필요로 하는 ADAS 학습용 고품질 소스 데이터 생성
이 프로젝트가 직면한 주요 도전 과제는 규모, 정밀도, 일관성 유지였습니다. 차선 경계는 카메라 각도, 조명, 노면 마모, 국가별 표시에 따라 복잡하고 변화무쌍합니다. ADAS 학습에 활용하려면 전체 데이터셋에 대해 높은 정확도와 균일한 품질이 필수적이었습니다.
수행 방식
팀 구성
폴리곤 라벨링 경험이 있는 총 12명의 전담 팀을 구성하였습니다. 각 팀원은 복잡한 시각 작업 경험을 기준으로 신중하게 선발하였으며, 프로젝트 착수 전 다음 내용을 포함한 집중 교육을 진행했습니다.
국가별 차선 표식 차이 이해
곡선, 원근감, 점점 가늘어지는 선 처리 등 다각형 주석 모범 사례
희미한 도색, 겹치는 차선, 야간 시야 불량 상황 등 까다로운 경우 주석 지침
파일럿 단계
소규모 데이터셋으로 파일럿을 진행해 프로세스를 시험했으며, 주석 결과에 대해 동료 검토 및 품질확인을 수행했습니다. 일부 손상 또는 부분적으로 보이는 차선 표시에 대한 처리 방식 차이가 발견되어 지침을 보완하고 팀 재교육을 실시했습니다.
본 작업 진행
파일럿 후 전체 생산 규모로 확장하였으며, 이미지 하나하나에 폴리곤으로 차선 경계와 곡선 및 부분 마킹을 세밀히 표시하였습니다. 주석 담당자가 자체 점검을 거쳐 제출한 뒤 동료 리뷰가 이루어졌고, 무작위 샘플은 고급 QA 전문가가 추가 검증하여 품질 통제를 강화했습니다. 2~3개월 차에 하루 수천 건 이상 주석을 수행하며 95% 이상의 정확도를 달성했고, 최종 달에는 98%를 넘겼습니다.
최종 납품
4개월 프로젝트 종료 시점에 16만 장 이상의 이미지가 폴리곤으로 정밀하게 주석 완료되었으며, 정확도는 지속적으로 98% 이상 유지되었습니다. 데이터셋은 예정된 일정에 맞춰 체계적인 폴더 구조와 즉시 활용 가능한 주석 파일 형태로 전달하였고, 명확한 문서와 QA 리포트를 포함하였습니다. 또한 클라이언트 팀과 최종 인수인계 회의를 진행해 데이터셋의 구성과 내용에 관해 설명하고 질의응답을 진행했습니다.
프로젝트 성과
160,000장 이상 이미지 폴리곤 주석 완료
주석 정확도 98% 이상
계획된 12명 팀으로 일정에 맞춘 납품 달성
자주 묻는 질문
폴리곤 라벨링이란 무엇인가요?
폴리곤 라벨링이란 객체의 가장자리를 따라 여러 개의 꼭짓점(vertex)을 배치해 다각형 형태로 윤곽을 그리는 어노테이션 기법입니다. 직사각형으로 단순화하는 바운딩 박스와 달리 객체의 실제 형태를 픽셀 단위로 포착할 수 있어, 차선이나 보행자처럼 윤곽이 불규칙한 대상에 특히 적합합니다.
폴리곤 라벨링은 모델 성능에 실제로 얼마나 영향을 미치나요?
배경 잡음을 줄여 데이터셋의 신호 대 잡음비를 개선하기 때문에 학습 효율이 높아집니다. 관련 연구에 따르면 폴리곤으로 라벨링된 데이터셋으로 학습한 모델은 바운딩 박스 기반 데이터셋 대비 객체 세그멘테이션 작업에서 약 18% 높은 정확도를 기록한 것으로 나타났습니다.
대규모 폴리곤 라벨링 프로젝트에서 가장 큰 난제는 무엇인가요?
수십만 장 규모의 데이터셋에서 모든 작업자가 동일한 기준으로 꼭짓점을 배치하도록 유지하는 일이 가장 어렵습니다. 특히 국가별 차선 표기 차이, 퇴색된 도색, 야간 저시정 환경처럼 판단이 엇갈리기 쉬운 상황에서는 명확한 가이드라인과 다단계 검수 체계가 반드시 필요합니다.
폴리곤 라벨링 파트너를 선정할 때 무엇을 확인해야 하나요?
자동차 산업 프로젝트 수행 실적, 실제 달성 정확도, 파일럿 검증 절차의 유무, 다단계 QA 체계, 그리고 프로젝트 규모 변화에 대응하는 인력 확장 역량을 종합적으로 검토하시기 바랍니다.
결론
폴리곤 라벨링은 자율주행 인지 모델이 도로 환경을 평면적 추정이 아닌 실제 형태 그대로 이해하도록 만드는 핵심 기법입니다. 불규칙한 차선 경계와 교통 표지판, 서로 겹쳐 있는 보행자, 그리고 사전에 정의하기 어려운 예외 상황까지 픽셀 단위로 정밀하게 포착함으로써, 배경 잡음을 줄이고 모델 정확도를 높이며 데이터 증강 효율까지 함께 개선합니다. 다만 이러한 이점은 기법 자체에서 자동으로 보장되는 것이 아니라, 명확한 클래스 정의와 숙련된 작업 인력, 그리고 다단계 품질 관리 체계가 뒷받침될 때 비로소 실현됩니다.
LTS Group의 차선 인식 프로젝트는 이 점을 분명하게 보여줍니다. 여러 국가에서 수집된 16만 장 이상의 이미지를 4개월 만에 98% 이상의 정확도로 완수할 수 있었던 것은 단순한 작업량 투입이 아니라, 사전 가이드라인 정립과 파일럿 검증, 맞춤 교육, 그리고 동료 검수와 시니어 QA로 이어지는 체계적인 워크플로우가 있었기 때문입니다.
ADAS와 자율주행 기술의 경쟁력이 결국 학습 데이터의 품질에서 결정된다는 점을 고려할 때, 검증된 데이터 솔루션 파트너와의 협업은 선택이 아닌 전략적 필수 조건입니다. 10년 이상 데이터 어노테이션 분야에 전념해 온 LTS Group은 다수의 한국 완성차 및 자율주행 기술 기업과 협업하며 축적한 노하우를 바탕으로, 귀사의 프로젝트가 요구하는 정확도와 일정을 함께 충족할 수 있도록 지원해 드립니다.
폴리곤 어노테이션 프로젝트를 검토 중이시라면, 지금 LTS Group에 문의하시어 무료 파일럿 프로젝트로 저희의 역량을 직접 확인해 보시기 바랍니다.
제조 현장에 AI가 빠르게 확산되고 있지만, 많은 기업이 데이터 문제로 AI 도입의 첫 단계에서 어려움을 겪고 있습니다. 설비와 시스템마다 분산된 데이터를 AI가 활용할 수 있는 형태로 정리하지 않으면, 아무리 정교한 AI도 기대한 성과를 내기 어렵기 때문입니다. 이에 따라 제조 데이터의 수집부터 통합, 품질 관리까지 책임지는 ‘AI 데이터 엔지니어링’ 파트너의 역할이 그 어느 때보다 중요해지고 있습니다.
이 글에서는 제조업 AI 데이터 엔지니어링 분야의 글로벌 대표 기업 10곳을 소개하고, 신뢰할 수 있는 기술 파트너를 선택할 때 반드시 확인해야 할 핵심 기준을 정리했습니다.
Table of Contents
Toggle
제조업을 위한 신뢰받는 글로벌 AI 데이터 엔지니어링 기업 LTS Group MakinaRocks ProdevbaseDatabricksLatenviewSnowflake Stxnext GroupBWTNTT data신뢰받는 제조업 AI 데이터 엔지니어링 벤더를 선택하는 방법인력 수준 및 제조업 도메인 전문성인증 및 준수 기준제조업에서 입증된 실적한국 기업과의 협업 경험2026년 제조업 AI 데이터 엔지니어링 시장 개요시장 규모성장 동인과 과제LTS 그룹의 제조업 AI 데이터 엔지니어링 역량 및 사례 연구자주 묻는 질문결론
제조업을 위한 신뢰받는 글로벌 AI 데이터 엔지니어링 기업
LTS Group
LTS Group
LTS Group(Lotus Technology Services)은 2016년에 설립된 베트남 IT 아웃소싱 기업으로, 소프트웨어 개발, 소프트웨어 테스트, 디지털 BPO 분야의 엔드 투 엔드 기술 서비스를 제공하고 있습니다. 데이터 엔지니어링 서비스에서는 성능, 비용, 거버넌스 간의 균형을 고려하여 데이터 아키텍처, ETL/ELT 파이프라인, 데이터 품질 검증 프레임워크를 설계·구축합니다. 이를 통해 기업 데이터가 AI 및 분석 이니셔티브의 신뢰할 수 있는 기반이 되도록 지원합니다.
위치: 베트남, 한국, 미국, 일본, 호주
제공 서비스
데이터 엔지니어링 수명 주기 전반 지원: 데이터 생성, 수집, 저장, 처리 및 변환(ETL/ELT), 서빙, 표준화된 데이터 거버넌스까지 6단계 핵심 프로세스를 지원합니다.
데이터 인프라 구축: 정형·반정형·비정형 데이터를 효율적으로 저장하기 위한 데이터 레이크, 데이터 웨어하우스, 레이크하우스 인프라를 구축합니다.
데이터 처리 및 변환: 데이터를 정리·보강·검증·재구성하고, 팩트 테이블, 차원 테이블, 집계 메트릭 형태로 제공합니다.
산업별 데이터 파이프라인: 제조, 건설, 이커머스 및 리테일, 금융, 물류, 헬스케어 분야에 최적화된 파이프라인을 설계합니다. 제조업의 경우 SCADA, MES, ERP 데이터의 실시간 동기화와 설비 종합효율(OEE) 모니터링, 예지보전 파이프라인 구축을 지원합니다.
LTS Group의 AI 데이터 엔지니어링 서비스를 자세히 보세요!
강점
산업별 전문성: 고정된 솔루션을 일괄 적용하지 않고, 각 산업의 운영 특성에 맞춰 파이프라인을 설계합니다.
AI 기반 데이터 엔지니어링: AI를 활용해 데이터 처리 속도를 높여, 정확도를 유지하면서도 구축 기간을 단축합니다.
풍부한 실무 경험을 갖춘 데이터 엔지니어: 다양한 프로젝트 경험을 갖춘 엔지니어가 참여하여 운영 과정의 기술적 리스크를 최소화합니다.
통합 데이터 생태계: 아키텍처 컨설팅부터 파이프라인 구축, 품질 검증까지 데이터 전체 라이프사이클을 단일 파트너가 책임지고 관리합니다.
보안 및 규제 준수: 암호화, 역할 기반 접근 제어(RBAC), 투명한 데이터 계보 관리를 통해 GDPR, HIPAA, ISO 27001을 준수합니다.
한국 고객 대응 경험: 10년간 한국 기업 고객과 협업해 온 경험을 바탕으로, 커뮤니케이션과 실행 전 과정에서 간극 없는 협업을 보장합니다.
대표적인 수치: IT 및 AI 분야 경력 10년, AI 전문가·소프트웨어 엔지니어·QA 인력 500명 이상, 성공적으로 완료한 프로젝트 270건 이상, 고객 재계약 및 협업 지속률 97%
고객 후기
“그들은 우리 직원들만큼 참여도가 높고 동기 부여가 잘 되어 있습니다. 지금까지 고객은 LTS Group의 계약에 만족하고 있습니다. 팀은 강력한 지속적인 파트너십을 구축하기 위해 직원만큼 열심히 일합니다. 또한 그들의 동기는 지속적으로 높은 수준의 서비스와 결과를 제공했습니다.”
– Katsunori Kurata, CEO, SQC Inc.
협업 모델: 전담팀, IT 직원 증강, 프로젝트 기반, 글로벌 개발 센터(GDC)
MakinaRocks
마키나락스는 2017년에 설립된 산업 특화 AI 기업으로, 엔터프라이즈 AI OS를 기반으로 현장에서 동작하는 인공지능을 만드는 피지컬 AI 대표 기업입니다. 공장에서 전장에 이르기까지 거칠고 예측 불가능한 환경에서 동작하는 피지컬 AI를 개발하며, 산업 특화 AI를 통해 완전 자율의 미래를 가속하는 것을 미션으로 삼고 있습니다.
위치: 대한민국 서울특별시
제공 서비스
엔터프라이즈 AI OS, Runway: 데이터 통합부터 배포, 운영 및 유지보수까지 AI 생애주기 전반을 관장하는 기업용 AI 운영체제입니다. 산업 현장에 특화된 AI를 빠르게 확장·운영하고, 다양한 엔터프라이즈 시스템과 연결해 오케스트레이션합니다.
Specialized AI: 자동차, 국방, 중공업, 제조 산업을 대상으로 전문가 증강, 제어, 예측 및 운영, 머신비전 분야의 AI 에이전트를 제공합니다. 연구개발·생산·공급망·유통 등 기업의 핵심 비즈니스 프로세스에 AI를 적용합니다.
DrawX: 도면 데이터를 기업의 표준 자산으로 전환하고, 검색부터 비교, 분석, 판단까지 자동화하는 AI 에이전트입니다.
강점
제조 현장에서 작동하는고성능 버티컬 AI 솔루션
산업 특화 AI 구현을 위한 다양한 개발 도구
현장에서 검증된 제품으로 신속한 AI 운영체제 구성
Prodevbase
ProDevBase Technologies는 미국 텍사스주 오스틴에 본사를 둔 디지털 혁신 서비스 기업입니다. 인공지능(AI), 데이터 분석, 클라우드 기술, 디지털 전환을 통해 기업의 조직적 과제를 해결하고 생산성과 성장을 지원합니다. AI 데이터 엔지니어링 서비스에서는 자율형 AI 시스템을 위한 저지연 데이터 환경과 고성능 파이프라인을 구축합니다. 이를 통해 기업 내 원천 데이터를 AI가 즉시 활용할 수 있는 맥락 기반 디지털 자산으로 전환합니다.
위치: 미국
제공 서비스
AI 데이터 엔지니어링 서비스는 다음 네 가지 핵심 영역으로 구성됩니다.
아키텍처 및 스토리지: Snowflake, Databricks, AWS S3 기반으로 AI에 최적화된 고성능 데이터 환경을 구축합니다. 벡터 데이터베이스와 중앙화된 피처 스토어도 함께 설계합니다.
실시간 처리: Kafka, Spark, Flink를 활용한 실시간 데이터 스트리밍 아키텍처로 기존 배치 처리 방식의 지연을 해소합니다.
거버넌스 및 품질: Great Expectations, Apache Atlas를 활용해 데이터 드리프트를 분석하고 컴플라이언스 통제를 자동화합니다. 임상 기록, 법률 계약서 등 복잡한 문서에 맞춘 청킹(Chunking) 전략도 설계합니다.
검색 최적화(RAG): 키워드 검색과 벡터 검색을 결합하고, 맞춤형 리랭킹 알고리즘과 지식 그래프를 통합하여 AI 에이전트에 정확한 데이터를 제공합니다.
강점
맞춤형 전문성: Prodevbase Technologies는 깊이 있는 기술 전문성과 실제 비즈니스 전략을 융합합니다.
풍부한 산업 경험: 이 조직은 의료 및 생명과학 분야에 대한 깊은 경험을 보유하고 있어, 엔지니어들이 해당 분야의 데이터 복잡성, 규제 환경, 근거 없는 AI 시스템이 초래할 수 있는 위험을 이해합니다.
완전한 클라우드 소유권: 기업 데이터는 내부에 안전하게 유지됩니다. 회사의 플랫폼이 고객 클라우드 환경 내에서 직접 구축되기 때문에, 조직은 모든 단계에서 완전한 소유권과 통제력을 가집니다.
측정 가능한 성과: 고객 도입 사례에서는 분석 성능 3배 향상, 데이터 처리 속도 50% 증가, 수작업 데이터 처리 60% 감소가 정기적으로 달성되고 있습니다.
맞춤형 솔루션: 쉽게 판매할 수 있는 것이 아니라, 실제 운영에 필요한 것을 정확히 구축합니다. Prodevbase 팀은 구조적 요구사항에서 출발하여 AI를 실무에 바로 적용할 준비가 된 기업과 긴밀히 협력합니다.
Databricks
Databricks는 ‘데이터 및 AI 기업(The data and AI company)’을 표방하는 글로벌 기업입니다. 2013년 레이크하우스 아키텍처와 오픈소스 프로젝트 Apache Spark™, Delta Lake, MLflow, Unity Catalog의 원 개발자들이 설립했습니다. 개방형 레이크하우스 아키텍처 기반의 데이터 및 AI 플랫폼을 통해 데이터와 거버넌스를 하나의 통합 기반 위에서 관리하고, 조직 고유의 특성에 맞춘 AI 모델을 결합하여 데이터와 AI의 대중화를 추진하고 있습니다. 현재 전 세계 2만 개 이상의 기업이 Databricks 플랫폼을 활용하고 있습니다.
위치: 미국
제공 서비스
통합된 수집, 변환 및 오케스트레이션
Genie Code를 활용한 에이전틱 파이프라인 개발
Genie ZeroOps를 통한 자율 파이프라인 운영
강점
85% 빠른 개발
50% 비용 절감
99% 파이프라인 지연 시간 감소
주간 4,500+ 작업 오케스트레이션 완료
Latenview
LatentView Analytics는 2006년 설립한 데이터 분석 및 AI 전문 기업입니다. 엔드 투 엔드 분석을 전문으로 하며, 2021년 분석 전문 기업으로서는 최초로 상장했습니다. 데이터 엔지니어링 서비스에서는 확장 가능한 데이터 인프라를 설계·구축·관리하여, 분산된 데이터를 분석·자동화·의사결정에 활용할 수 있는 신뢰도 높은 AI-ready 자산으로 전환합니다. Databricks Lakehouse 마이그레이션, Snowflake 데이터 웨어하우스 현대화, Azure·AWS 기반 실시간 파이프라인 구축, AI·ML용 데이터 인프라 구축까지 자문을 넘어 엔드 투 엔드 실행을 제공합니다.
위치: 미국
제공 서비스
데이터 마이그레이션
데이터 활성화
데이터 플랫폼 현대화
Databricks 및 Snowflake
클라우드 플랫폼
AI 데이터 엔지니어링
강점
20년 이상의 경험: 엔터프라이즈 데이터 플랫폼 현대화 분야에서 20년 이상의 경험과 Fortune 500 고객 기반을 보유하고 있습니다.
자체 마이그레이션 솔루션 MigrateMate: 플랫폼에 종속되지 않는 자동화 데이터 마이그레이션 솔루션입니다. Fortune 500 고객사 마이그레이션을 기한보다 2개월 앞당겨 완료하고, 연간 100만 달러 이상의 비용을 절감했습니다.
분석·AI 전문성과 엔지니어링 실행력의 결합: 전략 컨설팅부터 아키텍처 설계, 파이프라인 개발, 배포, 운영 관리까지 제공합니다.
산업별 맞춤 역량: 기술, 금융, CPG, 리테일, 제조 산업별 규제·운영·분석 요건에 맞춘 데이터 엔지니어링을 제공합니다. 금융 분야에서는 SOC 2, PCI-DSS 등 규제 대응 인프라를 구축합니다.
기술 파트너십: AWS, Azure, Databricks, Snowflake, Google Cloud, Fivetran, Neo4j, NVIDIA 등과 협력하고 있습니다.
Snowflake
Snowflake는 클라우드 기반의 AI Data Cloud 플랫폼을 제공하는 글로벌 기업으로, 모든 기업이 데이터와 AI를 통해 잠재력을 최대한 발휘할 수 있도록 지원하는 것을 미션으로 합니다. 데이터 엔지니어링 영역에서는 인프라 튜닝이 아닌 데이터 품질에 집중할 수 있는 ‘ZeroOps 데이터 엔지니어링’을 지향합니다. 무제한 상호운용성과 엔터프라이즈급 AI 기능으로 데이터를 생성 시점부터 인사이트 도출까지 AI-ready 상태로 만드는 것을 목표로 합니다. 현재 전 세계 12,062개 고객사가 Snowflake를 활용하고 있습니다(2025년 7월 31일 기준).
위치: 미국
제공 서비스
Snowflake for Data Engineering은 데이터 연결·변환·레이크하우스 영역으로 구성됩니다.
데이터 연결:
Snowflake Openflow: 개방형·확장형 관리형 멀티모달 데이터 통합 서비스
스트리밍 및 배치 수집, Snowpipe Streaming
Zero-Copy Integrations, Datastream
데이터 변환:
Snowpark: SQL·Python 등 다양한 언어로 데이터가 있는 곳에서 코드 실행
Snowpark Connect(Apache Spark 호환)
Dynamic Tables
dbt Projects on Snowflake
레이크하우스:
Apache Iceberg 기반 상호운용형 레이크하우스
Lakehouse Analytics, Polaris(Open Catalog)
Horizon Catalog, Snowflake Storage
강점
제로옵스 데이터 엔지니어링: 자신 있게 파이프라인을 코딩하고 자동화합니다.
무한한 상호운용성: 총소유비용(TCO) 절감, 성능 향상 및 공급업체 종속성을 감소합니다.
AI 가속화: AI의 약속을 실현합니다.
고객 후기
“Snowflake로 구축한 데이터 기반 덕분에 고객 데이터를 안전하고 비공개로 유지하면서도 빠르게 변화에 대응할 수 있게 되었습니다.”
– John Saunders, VP of Product, Power Digital
“일시적인 장애가 줄어들고 Snowflake에서 가시성이 높아지면서, 관리형 Spark보다 훨씬 운영하기 쉽고 비용 효율적인 플랫폼을 갖추게 되었습니다.”
– David Trumbell, Head of Data Engineering, CTC
Stxnext
STX Next는 2005년 폴란드에서 설립된 소프트웨어 엔지니어링 및 데이터·AI 전문 기업입니다. 산업(Industrial) 및 금융(Financial) 분야 경영진을 위한 ‘엔지니어링·비즈니스 스파링 파트너’를 표방합니다. 복잡한 클라우드·데이터 아키텍처를 정비하여 AI의 잠재력을 극대화하고, 지능형 솔루션을 일상 업무에 통합하는 것을 목표로 합니다. 데이터 엔지니어링 서비스에서는 레거시 시스템이나 분산된 데이터로 어려움을 겪는 중견·대기업을 대상으로 데이터 레이크하우스 구축, 파이프라인 개발, 애널리틱스 엔지니어링 등 엔드 투 엔드 서비스를 제공합니다.
위치: 폴란드
제공 서비스
산업용 데이터 파이프라인 및 특징 엔지니어링
시계열 데이터 처리 및 분석
예측 유지보수 및 자산 성능 분석
실시간 모니터링 및 보고 대시보드
강점
가동 중단 시간 50% 감소
유지보수 비용 40% 최적화
자산 수명 연장
향상된 작업 안전성
정밀한 예비 부품 관리
고객 후기
“그들의 전문성과 헌신이 원활하게 통합되어 프로젝트 전반에 걸쳐 매우 생산적이고 긍정적인 작업 환경을 조성했습니다. 팀은 숙련되고 대응이 빠르며 협업하기 쉽습니다. 피드백에 신속히 적응하고 마감일을 철저히 준수합니다. 품질 있는 결과를 제공하는 신뢰할 만한 파트너를 찾고 계시다면, 그들은 훌륭한 선택입니다.”
Laura Auchterlonie, Audit Technologies 제품 관리자, BSI, 영국
GroupBWT
GroupBWT는 2009년에 설립된 데이터 전문 IT 서비스 기업으로, 웹 스크래핑과 데이터 엔지니어링을 주력 분야로 합니다. 모든 비즈니스는 고유하며 하나의 솔루션이 모두에게 맞지 않는다는 철학 아래, 기업이 데이터를 수집·정리·분석할 수 있는 맞춤형 소프트웨어 솔루션을 제공합니다. 데이터 엔지니어링 서비스에서는 툴킷이 아닌 ‘성과’를 원하는 조직을 위해, 템플릿에 의존하지 않고 처음부터 설계한 맞춤형 데이터 시스템을 구축합니다.
위치: 영국
제공 서비스
대형 언어 모델(LLM) 및 에이전트를 위한 AI 준비 데이터 엔지니어링
의사결정 인텔리전스를 위한 실시간 데이터 스트림
데이터 가시성 및 입력 데이터 드리프트 감지
특징 저장소 및 메타데이터 시스템
기업 수준의 거버넌스 및 컴플라이언스
클라우드 네이티브 및 하이브리드 데이터 인프라
오케스트레이션 및 작업 자동화
데이터 메시 활성화
마이그레이션 엔지니어링 및 레거시 리팩토링
데이터 제품 엔지니어링
접근 계층이 포함된 웨어하우스 및 레이크하우스 시스템
조용히 실패하지 않는 ETL / ELT 시스템
강점
기본부터 구축: 템플릿에 얽매이지 않고 맞춤형 시스템을 구축합니다.
고급 전문성: 아키텍처는 데이터 자동화, 컴플라이언스, 플랫폼 마이그레이션 분야에서 15년 이상 경력을 가진 시니어 엔지니어들이 설계합니다.
언어 소통: CTO, 제품팀, 규제 당국과 직접 소통합니다. 불필요한 유행어 없이 문제 해결과 조율에 집중합니다.
미래 지향적 시스템: 시스템은 귀사의 전략과 함께 진화하며, 대형 언어 모델(LLM), 에이전트, 크로스 클라우드 오케스트레이션 및 AI에 대비되어 있습니다.
내부 통제: 복잡성을 외주하지 않습니다. 귀사의 플랫폼은 완전한 추적성, 감사 지원, 미래 대비를 갖춘 내부 관리로 운영됩니다.
파트너 같은 소유자 의식: 회복력과 명확성, 압박 속에서도 견디는 결과물을 위해 엔지니어링하며, 단순한 공급업체가 아닌 소유자처럼 귀사와 협력합니다.
안정적이고 유연한 플랫폼: GroupBWT 엔지니어들은 귀사의 비즈니스 로직과 변화하는 요구에 원활히 적응하는 미래형 플랫폼을 설계합니다.
오래가는 설계: 시스템에 문제가 있다면, 고장 난 부분을 진단하고 확장성, 회복력, 컴플라이언스를 고려한 견고한 기초를 설계합니다.
고객 후기
“솔루션 설계부터 구현까지 전반적으로 매우 뛰어난 역량을 갖추고 있습니다. GroupBWT는 일관되게 높은 품질의 오류 없는 결과물을 제공합니다.”
– Julian Martin, CTO, Job matching platform
NTT data
NTT DATA는 NTT 그룹 계열의 글로벌 IT 및 비즈니스 서비스 기업으로, 일본 도쿄에 본사를 두고 있습니다. 1988년에 설립되었으며, 컨설팅, 산업별 솔루션, 비즈니스 프로세스 서비스, IT 현대화, 매니지드 서비스를 통해 70개 이상 국가의 고객을 지원합니다. 데이터 엔지니어링 및 플랫폼 서비스에서는 현대적인 데이터 플랫폼 구축, 데이터 생태계 확장, 데이터 파이프라인 활성화를 통해 의사결정을 개선하고 비즈니스 성과 창출을 지원합니다.
위치: 일본
제공 서비스
데이터 플랫폼 전략: 이상적인 목표 상태로의 로드맵을 수립하고, 데이터를 원천·정제·분석 계층으로 구성하며, 적절한 수집·변환·통합 패턴을 결정합니다.
플랫폼 현대화 전략: 기존 및 클라우드 데이터 플랫폼 경험을 바탕으로, 향후 요구에 유연하게 대응하는 의사결정 기반을 구축·유지합니다.
비용 최적화: 검증된 프레임워크로 과거 또는 잠재적 투자를 평가하고 하이퍼스케일러 사용을 최적화합니다.
데이터 플랫폼 및 파이프라인 구축: 다양한 데이터 소스를 수집·변환·정제·정규화하는 플랫폼 기반을 구축합니다.
데이터 플랫폼 운영: 매니지드 서비스를 통해 데이터 감사, 플랫폼 상태 관리, 대규모 개선 작업을 지원합니다.
강점
1만 명 이상 데이터 및 인텔리전스 전문가: 데이터 및 인공지능 실무 조직은 전 세계 포춘 500대 기업에 서비스를 제공하는 1만 명 이상의 전문가로 구성되어 있습니다.
7개 글로벌 데이터 및 AI 혁신 센터: 이 회사는 데이터 및 AI 혁신 센터는 신기술과 공동 연구개발에 집중하며 비즈니스 성장을 견인합니다.
Yearling Solution
Yearling Solutions는 사이버보안 자문, AI 혁신, 인재 파견, 제품 개발을 하나의 모델로 통합하여 제공하는 기술 컨설팅 기업입니다. 기존 컨설팅의 방식을 따르기보다 새롭게 정의하는 것을 목표로 하며, 조직이 더 빠르고 체계적으로 움직일 수 있도록 지원합니다. AI & 데이터 엔지니어링 서비스에서는 AI 전략 수립부터 데이터 플랫폼 설계, 프로덕션 ML 시스템 배포까지 측정 가능한 비즈니스 가치를 창출하는 엔드 투 엔드 솔루션을 제공합니다.
제공 서비스
AI 전략 및 로드맵: 고가치 AI 활용 사례 발굴, ROI 분석 및 우선순위 설정, 단계별 실행 계획 수립, LLM 평가 및 모델 선정(GPT, Claude, Llama, Mistral)
데이터 플랫폼 설계: 클라우드 데이터 웨어하우스(Snowflake, BigQuery, Redshift), 데이터 레이크·레이크하우스(Databricks, Delta Lake), 실시간 스트리밍(Kafka, Kinesis)
ML 인프라 및 파이프라인: MLOps 플랫폼(MLflow, Kubeflow, SageMaker), ETL/ELT 파이프라인(Airflow, dbt, Fivetran), 데이터 품질 검증 프레임워크
분석 및 거버넌스: BI 플랫폼(Tableau, Power BI, Looker) 구축, 데이터 카탈로그·메타데이터 관리, 접근 제어 및 데이터 계보 추적
강점
빠른 프로덕션 전환: ‘AI QuickLaunch’ 패키지로 4~6주 내 프로덕션 수준의 AI MVP를 제공합니다.
실무 전문가 중심: 제너럴리스트가 아닌 실무 전문가가 직접 프로젝트를 수행합니다.
PoC가 아닌 실제 시스템: 개념 검증에 그치지 않고 실제 운영 가능한 프로덕션 시스템을 구축합니다.
완전한 지식 이전: 팀 교육, 기술 문서, 전체 코드 인계를 기본으로 포함합니다.
산업 특화 역량: 헬스케어(HIPAA 준수 AI), 금융(SR 11-7 모델 거버넌스), 공공(FedRAMP 인증 데이터 플랫폼), 제조(예지보전, OT/IT 데이터 통합) 분야에 특화된 솔루션을 제공합니다.
Indium
Indium은 Agentic AI, 데이터·분석, 애플리케이션 엔지니어링, 품질 엔지니어링을 전문으로 하는 AI 서비스 기업입니다. 약 30년 전 엔지니어링 팀으로 출발해 인터넷, 클라우드, 데이터, AI에 이르기까지 주요 기술 전환을 꾸준히 받아들이며 성장해 왔습니다. 데이터 엔지니어링 서비스에서는 원천 데이터 수집부터 AI-ready 결과물 산출까지, 단순히 흐르는 것을 넘어 스스로 적응하는 프로덕션 수준의 데이터 파이프라인을 설계합니다.
위치: 미국
제공 서비스
AI 증강 데이터 파이프라인: 수집·변환·품질 검사·모니터링을 AI 기반으로 자동화
데이터 아키텍처: 성능, 거버넌스, 장기 확장성을 고려한 데이터 레이크, 웨어하우스, 파이프라인 설계
데이터 수집: 정형·비정형·스트리밍 데이터를 중앙 저장소로 수집하는 고속·보안 파이프라인
데이터 거버넌스: 계보, 일관성, 감사 가능성을 갖춘 거버넌스 프레임워크
데이터 레이크하우스: 실시간 분석 및 AI 워크로드를 위한 레이크하우스 구축
데이터 가상화: 데이터 복제 없이 분산 데이터를 단일 계층에서 접근
데이터 마이그레이션: 자체 솔루션 ‘Data Lifter’로 스키마 분석, 데이터 프로파일링, 계보 매핑, 컴플라이언스 점검 자동화
강점
AI 활용 운영 자동화: AI 에이전트가 스키마 드리프트를 감지하고, ML 모델이 부하 패턴에 따라 작업 일정을 최적화합니다. 데이터 품질 점수화를 통해 경보에 그치지 않고 개선 방안까지 제시합니다.
가치 실현 기간 단축: 재사용 가능한 프레임워크와 가속기로 AI·분석 이니셔티브를 수주 내에 시작할 수 있습니다.
비즈니스 목표 정렬: 모든 파이프라인과 데이터 모델을 비즈니스 목표에 연결합니다.
풀스택 역량: 수집부터 활용까지 데이터 여정 전체를 직접 책임집니다.
플랫폼 중립성: Azure, Amazon Bedrock, Vertex AI, BigQuery, Delta Lake, Snowflake, Databricks, Kafka, Airflow, dbt, MLflow 등 상황에 맞는 기술을 선택합니다.
신뢰받는 제조업 AI 데이터 엔지니어링 벤더를 선택하는 방법
제조업의 AI 데이터 엔지니어링은 일반적인 IT 프로젝트와 다릅니다. SCADA, MES, ERP 등 서로 다른 시스템에서 발생하는 데이터를 실시간으로 통합해야 하고, 생산 현장의 운영 특성과 보안 요건까지 함께 고려해야 하기 때문입니다. 따라서 벤더를 선택할 때는 기술 스택이나 견적만으로 판단하기보다 ‘제조 현장을 이해하고, 검증된 방식으로, 안정적으로 협업할 수 있는가’를 기준으로 살펴볼 필요가 있습니다. 다음 네 가지 기준을 중심으로 후보 벤더를 비교해 보시기 바랍니다.
인력 수준 및 제조업 도메인 전문성
가장 먼저 확인해야 할 것은 실제 프로젝트에 투입될 인력의 역량입니다. 제조 데이터는 설비 센서 데이터, 공정 로그, 품질 검사 결과 등 형식과 생성 주기가 제각각이므로, 데이터 엔지니어링 기술과 함께 제조 공정에 대한 이해가 필수적입니다. 도메인 이해가 부족한 팀은 기술적으로 완성도 높은 파이프라인을 만들더라도, 현장에서 실제로 필요한 데이터를 놓치기 쉽습니다.
체크포인트
데이터 엔지니어의 경력 수준과 투입 인력 구성(아키텍트, 엔지니어, QA 등)
OEE 모니터링, 예지보전, 품질 분석 등 제조 특화 활용 사례에 대한 이해도
OT(운영 기술)와 IT 시스템 간 데이터 연계 경험
인증 및 준수 기준
인력의 역량이 확인되었다면, 그 역량이 체계적인 기준 아래에서 운영되는지도 점검해야 합니다. 제조 기업의 생산 데이터와 설계 정보는 핵심 자산이므로, 벤더가 국제 표준에 따른 보안·품질 관리 체계를 갖추고 있는지가 중요합니다. 인증은 벤더의 프로세스 성숙도를 객관적으로 보여주는 지표이기도 합니다.
체크포인트
정보보안 인증(ISO 27001) 및 품질경영 인증(ISO 9001) 보유 여부
자동차 산업의 경우 TISAX 등 업종별 보안 인증 보유 여부
개인정보보호법, GDPR 등 관련 규정 준수 체계와 데이터 접근 통제 방식
제조업에서 입증된 실적
역량과 체계를 갖추었더라도, 실제 제조 현장에서 성과를 낸 경험이 있는지는 별개의 문제입니다. 제조 데이터 프로젝트는 설비 다양성, 레거시 시스템 연동, 현장 운영 중단 리스크 등 예상하지 못한 변수가 많기 때문에, 유사한 환경에서의 수행 경험이 프로젝트 성공 가능성을 크게 좌우합니다.
체크포인트
제조업 프로젝트 사례와 정량적 성과(가동 중단 시간 감소, 비용 절감 등)
귀사와 유사한 업종·규모의 고객 레퍼런스
파일럿(PoC)에서 전사 확산까지 이어진 사례가 있는지 여부
한국 기업과의 협업 경험
마지막으로, 해외 벤더를 고려하는 경우라면 한국 기업과의 협업 경험을 반드시 확인해야 합니다. 아무리 뛰어난 기술력을 갖춘 벤더라도 커뮤니케이션 방식, 보고 체계, 업무 문화의 차이로 인해 프로젝트 속도와 품질이 떨어질 수 있습니다. 특히 제조 현장은 빠른 의사결정과 긴밀한 조율이 필요한 만큼, 한국 기업의 업무 방식에 익숙한 파트너가 리스크를 크게 줄여줍니다.
체크포인트
한국 기업과의 프로젝트 수행 경험 및 기간
한국어 커뮤니케이션 지원 여부와 한국 내 지사 또는 담당 조직 운영 여부
한국 기업의 보고 체계와 문서화 요구 수준에 대한 이해도
2026년 제조업 AI 데이터 엔지니어링 시장 개요
시장 규모
Fortune Business Insights에 따르면, 글로벌 제조업 빅데이터 시장 규모는 2025년 79억 4천만 달러로 평가되었으며, 2026년 91억 1천만 달러에서 2034년 301억 5천만 달러로 성장하여 예측 기간 동안 연평균 성장률(CAGR) 16.10%를 기록할 것으로 전망됩니다. 2025년 기준 북미가 39.50%의 점유율로 시장을 주도했습니다.
데이터 위에서 작동하는 제조 AI 시장은 이보다 더 빠르게 성장하고 있습니다. MarketsandMarkets는 글로벌 제조업 AI 시장이 2025년 341억 8천만 달러에서 2030년 1,550억 4천만 달러로, 연평균 35.3% 성장할 것으로 예측했습니다. 데이터 인프라와 AI 활용이 함께 확대되는 만큼, 그 기반을 구축하는 데이터 엔지니어링 수요도 꾸준히 증가할 것으로 보입니다.
성장 동인과 과제
시장 성장의 가장 큰 동인은 제조 현장에서 생성되는 데이터의 급증입니다. 제조 현장의 IoT 기기와 센서 사용이 늘면서 대량의 데이터가 생성되고, 이를 처리하고 정보를 추출하기 위한 빅데이터 분석의 필요성이 커지고 있습니다.
반면 데이터 품질과 통합 문제는 여전히 큰 과제로 남아 있습니다. 레거시 제조 시스템은 데이터가 분절되어 있거나 불완전한 경우가 많아 AI 기반 인사이트의 효과를 제한합니다. 또한 데이터 보안 리스크와 시스템 통합의 어려움도 도입을 가로막는 요인으로 꼽힙니다. 결국 제조 AI의 성공 여부는 분산된 데이터를 얼마나 안정적으로 연결하고 정제하느냐에 달려 있다고 할 수 있습니다.
주요 트렌드
첫째, 보안과 지식재산 보호를 중시하는 제조업 특성상 온프레미스 환경이 여전히 강세입니다. 2024년 제조업 빅데이터 분석 시장에서 온프레미스 배포는 52.6%의 점유율을 유지하며, 결정론적 제어와 지식재산 보호를 위한 역할을 확고히 했습니다.
둘째, 생성형 AI가 제조 데이터 활용의 새로운 축으로 부상하고 있습니다. 기술별로는 생성형 AI 부문이 2025~2030년 가장 빠르게 성장할 것으로 예상됩니다.
셋째, 산업 데이터를 전문적으로 다루는 ‘Industrial DataOps’가 독립된 시장으로 자리 잡고 있습니다. IDC가 2026년 처음으로 Worldwide Industrial DataOps Platforms 부문 MarketScape를 발표한 것은, 산업 데이터 수명주기 관리의 전략적 중요성이 커지고 있음을 보여줍니다.
LTS 그룹의 제조업 AI 데이터 엔지니어링 역량 및 사례 연구
AR/VR 동작 및 환경 상호작용 데이터셋 수집
고객사 개요
미국 고객사는 로봇의 pick-and-place 작업 환경에서 AI 모델을 학습시키기 위해 사용자 행동 데이터를 수집하는 프로젝트를 진행 중입니다. 참여자들은 AR/VR 헤드셋(PICO 4 Ultra)과 다섯 개의 모션 트래커를 사용하여 실내, 공공 장소, 산업 환경 등 다양한 환경에서 물체의 움직임과 상호작용을 기록합니다.
비즈니스 과제
고정밀 로봇 데이터 요구사항 :
로봇 학습용 데이터는 실제 pick-and-place 작업을 시뮬레이션하기 위해 정확한 동작 캡처와 일관된 상호작용 패턴을 필요로 합니다.
복잡한 환경 분포: 데이터 수집은 여러 환경을 균형 있게 반영해야 합니다.
60% 실내 가정
30% 소매/공공
5-10% 산업이나 제한 구역
5개월 간의 대규모 안정적인 인력 운영이 필요합니다.
AR/VR 장비 및 트래커와 같은 특수 장비는 엄격한 자산 관리가 요구됩니다.
일일 데이터 업로드가 필요하므로 안정적인 네트워크 인프라가 필수입니다.
일일 작업 시간을 20시간에서 100시간으로 확대할 때에도 작업 일관성을 유지해야 합니다.
프로젝트 정보
예상 결과물: 로봇 동작 및 환경 상호작용 데이터셋
총 목표: 10,000시간 데이터 수집 (2026년 4월~8월)
위치: 필리핀, 베트남, 태국, 인도네시아, 말레이시아
LTS 솔루션
확장 가능한 데이터 수집 운영 구축
지역별 팀을 구성하여 채용과 참여자 일정 관리를 진행
5개국에 걸쳐 데이터 수집을 조율
9개월간 안정적인 인력 운영 유지
고품질 로봇 동작 캡처 보장
AR/VR 헤드셋과 모션 트래커를 배치하여 정확한 동작 기록 수행
Pick-and-place 작업을 위한 표준화된 참여자 워크플로우 적용
매일 기기 점검 및 환경 검증 시행
대규모 생산 일관성 유지
참여자별 일일 업로드 성과 모니터링
안정적인 인터넷 연결 및 하드웨어 가용성 확보
데이터 불일치 방지를 위한 품질 모니터링 적용
사용 기술
PICO
Motion Tracking System
주요 결과
50+ 참여자
10K 데이터 수집 시간
5 국가
5 개월
자주 묻는 질문
제조업 AI 데이터 엔지니어링이란 무엇인가요?
제조업 AI 데이터 엔지니어링은 설비 센서, SCADA, MES, ERP 등 제조 현장의 다양한 시스템에서 발생하는 데이터를 수집·정제·통합하여, AI와 분석에 바로 활용할 수 있는 형태로 만드는 작업입니다. 데이터 파이프라인 구축, 데이터 레이크·웨어하우스 설계, 데이터 품질 관리와 거버넌스까지 포함하며, 예지보전이나 품질 분석 같은 제조 AI 활용의 기반이 됩니다.
AI 도입 전에 데이터 엔지니어링이 먼저 필요한 이유는 무엇인가요?
AI는 정제되고 구조화된 최신 데이터로 학습할 때에만 정확한 결과를 낼 수 있습니다. 제조 데이터는 시스템마다 형식과 생성 주기가 달라 분산되어 있는 경우가 많고, 이 상태로는 아무리 정교한 AI 모델도 왜곡된 결과를 내기 쉽습니다. 따라서 데이터 엔지니어링은 AI 투자의 성과를 좌우하는 선행 단계라고 할 수 있습니다.
해외 벤더와 협업할 때 주의할 만한 점은 무엇인가요?
기술력만큼 중요한 것이 커뮤니케이션과 업무 방식의 적합성입니다. 한국 기업과의 협업 경험, 한국어 소통 지원, 국내 지사나 전담 조직의 운영 여부를 반드시 확인해야 합니다. 또한 제조 데이터는 핵심 자산이므로 정보보안 체계와 데이터 접근 통제 방식도 계약 전에 꼼꼼히 점검하는 것이 좋습니다.
결론
제조업의 AI 전환이 가속화되면서, 경쟁력의 핵심은 ‘AI를 도입했는가’에서 ‘AI를 뒷받침할 데이터 기반을 갖추었는가’로 옮겨가고 있습니다. 글로벌 제조 빅데이터 시장이 꾸준히 성장하고, 한국 정부도 ‘제조AI 2030 전략’을 통해 제조 데이터를 국가 전략의 중심에 둔 만큼, 데이터 엔지니어링에 대한 투자는 이제 선택이 아닌 필수가 되었습니다.
이 글에서 소개한 기업들은 플랫폼 제공부터 맞춤형 구축 서비스, 산업 특화 AI 솔루션까지 각기 다른 강점을 지니고 있습니다. 중요한 것은 기업의 현재 데이터 성숙도와 목표에 맞는 파트너를 선택하는 것입니다. 앞서 살펴본 인력 역량, 인증 및 준수 기준, 제조업 실적, 한국 기업과의 협업 경험이라는 네 가지 기준을 바탕으로 후보 벤더를 비교해 보시기 바랍니다.
LTS Group은 10년간 한국 기업과 협업해 온 경험을 바탕으로, SCADA·MES·ERP 데이터 통합부터 데이터 품질 검증, 거버넌스까지 제조 데이터 엔지니어링의 전 과정을 단일 파트너로서 지원합니다. 제조 AI 도입을 위한 데이터 기반 구축을 검토 중이시라면, LTS Group의 전문가와 상담을 통해 귀사에 맞는 첫 단계를 함께 설계해 보시기 바랍니다.
생성형 AI 도입이 확산되면서 기업의 관심은 질문에 답하는 챗봇을 넘어, 업무를 스스로 계획하고 실행하는 에이전틱 AI로 옮겨가고 있습니다. 그러나 AI 에이전트는 모델 하나를 연결한다고 완성되지 않습니다. 업무 프로세스 이해, 기존 시스템 연동, 보안·거버넌스, 운영 모니터링이 함께 갖춰져야 하므로 AI 에이전트 개발 기업을 어떻게 선정하느냐가 프로젝트의 성패를 좌우합니다.
현재 시장에는 글로벌 컨설팅 기업, AI 플랫폼 기업, 엔지니어링 전문 기업, 국내 AX 기업 등 다양한 유형의 공급자가 있으며, 기업마다 서비스 범위와 강점이 다릅니다. 이 글에서는 2026년 주요 AI 에이전트 개발 기업 10곳의 서비스와 강점을 각 기업의 공식 웹사이트 정보를 바탕으로 정리하고, 신뢰할 수 있는 파트너를 선택하기 위한 기준을 함께 안내해 드립니다. IT 서비스 기업의 의사결정권자와 CTO, PM께서 도입 파트너를 비교·검토하시는 데 도움이 되기를 바랍니다.
Table of Contents
Toggle
AI 에이전트 개발 기업 – 제공 서비스 및 강점LTS Group Bigshift ProTenChisoftware Neurons lab Globant Plavno Qubika Softermii One Two Three 신뢰할 수 있는 AI 에이전트 개발 파트너를 선택하는 방법인력 역량 및 AI 에이전트 전문성인증 및 규정 준수 기준AI 분야에서 검증된 실적한국 기업과의 협업 경험LTS Group의 AI 에이전트 개발 사례 연구 자주 묻는 질문 마무리
AI 에이전트 개발 기업 – 제공 서비스 및 강점
LTS Group
LTS Group은 베트남을 대표하는 IT 아웃소싱 전문 기업으로, 전 세계 기업이 장벽을 허물고 성장할 수 있도록 지원하고 있습니다. 소프트웨어 개발(웹·모바일 앱, 블록체인, AI 개발, 데이터 엔지니어링, SDV용 임베디드 소프트웨어), 소프트웨어 테스트, 디지털 BPO(AI 데이터 어노테이션, RPA 등) 분야에서 서비스를 제공하며, 전담 팀, IT 인력 파견, 프로젝트 단위 계약, GDC(글로벌 개발 센터) 등 고객 상황에 맞는 다양한 협업 모델을 운영하고 있습니다.
위치: 베트남 (본사), 한국, 미국, 일본, 호주 (지사)
AI 에이전트 개발 서비스
LTS Group은 컨설팅부터 개발, 테스트, 배포 후 운영까지 하나의 파트너가 책임지는 통합 AI 에이전트 개발 생태계를 제공합니다.
AI 전환 컨설팅: 발굴 → 정의 → 개발 → 배포 → 운영 → 확장의 6단계 여정을 함께합니다.
맞춤형 AI 에이전트 개발: 고유한 업무 로직과 깊은 시스템 통합이 필요한 기업에 적합합니다.
AI 에이전트 통합: 기존 시스템과 연동하여 보안·접근 통제까지 설계합니다.
Agent as a Service: 빠른 도입이 필요하거나 대규모 투자 전 검증을 원하는 기업에 적합합니다.
Beacon: LTS Group이 자체 개발한 AI 에이전트 플랫폼으로, 하나의 인터페이스에서 여러 에이전트를 구축·관리할 수 있습니다.
강점
통합 생태계: 컨설팅·개발·테스트를 단일 파트너가 관리하므로 여러 벤더를 조율할 필요가 없습니다.
보안 및 규정 준수: Compliance-First 원칙에 따라 GDPR, HIPAA, ISO 27001, AI Act에 부합하도록 에이전트를 구축합니다.
한국 고객과의 10년 협업 경험: 원활한 소통과 실행을 지원합니다.
검증된 실적: 10년의 IT·AI 경험, 500명 이상의 AI 전문가·소프트웨어 엔지니어·QA 인력, 270건 이상의 프로젝트, 97%의 고객 재계약 및 협업 지속률을 보유하고 있습니다.
Bigshift
빅시프트는 기업 맞춤형 AI 소프트웨어 개발사입니다. 고객의 실제 업무와 시스템 가까이에서 문제를 정의하고, 기업에 필요한 AI 소프트웨어를 설계·개발하며, RAG 챗봇, AI 에이전트, NL2SQL, 업무 자동화 분야의 프로젝트를 수행하고 있습니다. 2026년 3월 AI 바우처 공급기업으로 선정되었습니다. 2026년 8월에는 OpenAI와 Microsoft의 공식 파트너로 선정되었습니다.
AI 에이전트 개발 서비스
빅시프트는 FDE(Forward Deployed Engineer)형 AI 개발 방식을 제공합니다. FDE란 고객의 실제 업무와 시스템 가까이에서 문제 발견, 기술 범위 설정, 직접 개발, 평가, 배포, 운영 정착까지 연결하는 엔지니어링 방식입니다.
AI 에이전트·MCP: 일반 챗봇과 달리 업무 도구 호출, 데이터 조회, 문서 생성, 검증, 후속 액션까지 수행하는 시스템을 구축합니다.
RAG 챗봇: PDF, 워드, 엑셀, 내부 위키, NAS 문서, 웹 페이지, 데이터베이스 등 기업 내부 자료를 기반으로 구축합니다.
NL2SQL 데이터 탐색: 자연어 질문으로 데이터를 조회하는 시스템을 구축합니다.
맞춤형 AI 솔루션: 노코드 AI 에이전트 빌더, AI PPT 생성기, AI UX Writer, AI Persona Interview, RFP 기반 제안서 생성기 등 구축 이력이 있습니다.
보안 대응: 데이터 반출 제한, 내부망, 권한 통제, 감사 로그, 온프레미스 요구사항을 검토하여 아키텍처를 설계합니다.
진행 방식: 무료 상담 후 착수 전에 시제품과 제품화 로드맵을 공유하며, PoC 이후 운영 전환까지 고려하여 설계합니다. 홈페이지에서는 “3일 내 시제품 제작”을 제시하고 있습니다.
강점
FDE 기반 밀착 개발: 문제 정의부터 개발, 배포, 운영 정착까지 한 팀이 연결합니다.
풀스택 AI 개발 역량: 기획부터 AI 제품 개발까지 하나의 팀에서 수행합니다.
빠른 검증: 착수 전 시제품과 제품화 로드맵을 공유하여 의사결정 부담을 줄입니다.
엄격한 보안 설계: 내부망·온프레미스·권한 통제·감사 로그 요건을 반영합니다.
솔직한 기술 검토: 구현이 어려운 기획은 근거와 함께 전달합니다.
다양한 도메인 경험: 금융, 통신, 공공, 대학, B2B 세일즈 등 여러 산업의 프로젝트를 수행했습니다.
ProTen
(주)프로텐은 인공지능(AI) 솔루션 및 Microsoft 솔루션 구축 전문 기업입니다. AI 자연어 이해 기술과 빅데이터·데이터 분석 플랫폼을 기반으로 통합 검색엔진, 생성형 AI 검색, sLLM, RAG, 챗봇, 문서 파싱, 회의록 자동 작성 등 다양한 AI 솔루션을 자체 개발하여 제공하고 있습니다. 또한 Microsoft 365 및 Teams 연동 Add-in 솔루션, IT 인프라, 시스템 운영, IT 아웃소싱 서비스도 함께 제공합니다.
AI 에이전트 개발 서비스
프로텐은 엔터프라이즈 AI 통합 플랫폼 ProGenAI Studio v2.0을 통해 Agentic AI 기술을 도입하고 있으며, “AI가 답하는 시대에서 실행하는 시대로”라는 방향을 제시합니다. 검색으로 맥락을 만들고, 워크플로우로 판단을 연결하며, 프롬프트와 LLM으로 실행을 완성하는 3단계 구조입니다.
플랫폼 구성
AI 에이전트: AI 검색 서비스, AI 포털, AI 비서, 회의록 자동 작성, Text-to-SQL
ProsLLM: 자체 개발 sLLM, LLM API, 임베딩 학습, 모델 커넥터, 오픈소스 LLM 연동
ProVSearch·ProRAG: 대화 프레임, 인텐트 분류, 워크플로우, 프롬프트·템플릿, 서비스 배포·평가·모니터링, API 관리
ProLLMOps v2.0: 모델 등록·배포·평가, 학습 이력·자원·데이터 관리, RAG 데이터 관리, 벡터 DB 구축, 에이전트 관리, 파인튜닝, 도구 관리
ProLLMOps는 코드 없이 GUI 기반 워크플로우로 LLM 운영과 RAG 시스템을 구성할 수 있는 노코드 환경을 제공하며, 에이전틱 AI가 의도 분석, 분기 처리, LLM 검증을 자동화하여 복잡한 질의에 답변합니다. 시맨틱·문단·문자 단위 청킹, 키워드·벡터·하이브리드 검색과 리랭커, 실시간 로그·사용량 모니터링, 프롬프트 튜닝 도구도 포함합니다.
강점
검색·판단·실행의 통합 구조: 검색, 워크플로우, 프롬프트·LLM을 하나의 흐름으로 연결합니다.
자체 개발 기술 스택: sLLM(ProsLLM), LLMOps, RAG, 검색엔진을 직접 개발하여 하나의 플랫폼으로 제공합니다.
노코드 워크플로우: 코드 수정 없이 워크플로우로 구성할 수 있어 도입 속도를 높이고 AI의 판단 과정을 명시적으로 설계할 수 있습니다.
유연한 배포: 클라우드와 온프레미스를 모두 지원합니다.
공공·금융 분야 레퍼런스: 국회사무처, 한국관광공사, 성남시, SK AX 등 공공·민간 기관의 구축 경험을 보유하고 있습니다.
공인 인증: GS인증 1등급, 이노비즈, NIA AI 윤리 준수기관 선정, 조달청 나라장터 등록
협업 솔루션 전문 집단: Microsoft 365·Teams 연동 솔루션 경험을 바탕으로 한 의사소통·협업 기반 솔루션 제공
Chisoftware
CHI Software는 20년간 성장해 온 엔지니어링 파트너 기업입니다. 현재 800명 이상의 전문 인력이 16개 엔지니어링 팀과 5개 제품 지원 팀으로 구성되어 있으며, 2024년 브랜드를 리뉴얼하면서 AI, 데이터·애널리틱스, 클라우드 3대 축으로 사업을 집중했습니다. 핀테크, 에듀테크, 헬스케어, 보험, 리테일, 물류 등 다양한 산업의 고객을 지원합니다.
본사 및 주요 거점은 폴란드, 스페인, 키프로스, 미국, 우크라이나이며, ISO 27001과 ISO 9001 인증을 보유하고 있습니다. Microsoft Solutions Partner(Digital & App Innovation), AWS, Databricks 파트너이며, IAOP 글로벌 아웃소싱 100대 기업(2023~2025년)에 이름을 올렸습니다.
에이전틱 AI 개발 서비스
CHI Software는 에이전트 설계부터 구축, 운영까지 지원하는 Agentic AI Development Services를 제공합니다.
Agentic AI 아키텍처 설계: 오케스트레이션, 도구, 메모리, 연동, 보안, 관측 가능성(observability) 설계
맞춤형 AI 에이전트 개발: 정액제, T&M, BOT 등 계약 모델 선택 가능
멀티 에이전트 시스템 개발: 오케스트레이션, 통신 프로토콜, 공유 상태, 거버넌스 구축
엔터프라이즈 Agentic AI 도입: AWS·Azure·GCP 환경에서 보안·규정 준수, CRM/ERP/데이터 플랫폼 연동, 모니터링 지원
CHI Software의 강점
직접 사용하며 검증한 경험(Dogfooding): Claude Code 기반으로 운영하며, 서비스 제공 전에 자체 에이전트 10개를 구축하여 운영했습니다.
AI 전문성: AI·NLP·ML 분야 박사급 연구진과 ACL, PLoS 등의 논문 발표 이력, Google Cloud·AWS·DeepLearning.AI 관련 30개 이상의 자격을 보유하고 있습니다.
운영 중심 설계: 거버넌스, 관측 가능성, 롤백 기준을 초기 단계부터 포함합니다.
벤더 중립성: AWS, Azure, GCP 중 어느 환경에서도 특정 독점 툴체인에 종속되지 않으며, 인프라는 고객 저장소에 문서화됩니다.
유연한 협업 모델: 팀 확장 또는 전체 구축 중 선택할 수 있습니다.
글로벌 보안·품질 인증: ISO 27001, ISO 9001 보유
Neurons lab
Neurons Lab은 2019년에 설립된 금융 서비스(FSI) 특화 AI 엔지니어링 파트너입니다. “AI에 대한 기대를 안전하고 확장 가능하며 상업적 가치를 창출하는 솔루션으로 전환한다”는 미션 아래, AI 도입의 인식과 실제 업무 현장 실행 사이의 간극을 해소하는 데 주력하고 있습니다.
유럽 전역의 AI 엔지니어, 아키텍트, 애널리스트 50명 이상이 소규모 시니어 팀으로 활동하며, 2019년 설립 이후 포춘 500대 기업을 포함하여 100건 이상의 AI 구현 실적을 보유하고 있습니다. 공동 창업자는 알렉스 혼차르(CTO)와 이고르 시도렌코(CEO)이며, 영국 런던과 싱가포르에 거점을 두고 있습니다.
AI 에이전트 개발 서비스
Neurons Lab은 금융 서비스 환경을 위한 맞춤형 AI 에이전트(Custom AI Agents)를 발굴 단계부터 파일럿, 운영 환경 배포까지 지원합니다. 서비스는 맞춤형 AI 에이전트 개발과 AI 교육·역량 강화(AI Training and Enablement) 두 가지로 구성됩니다.
강점
규제 환경에 특화된 설계: 거버넌스, 보안, 감사 가능성이 중요한 금융 환경을 전제로 구축합니다.
운영 중심 아키텍처: 초기 단계부터 거버넌스, 업무 적합성, 확장성을 고려하여 설계합니다.
재사용 자산: 금융 서비스용 사전 구축 에이전트 컴포넌트, 재사용 가능한 스킬, 검증된 패턴으로 도입 속도를 높입니다.
고객 팀과의 공동 창조: 지식 이전을 통해 고객이 장기적으로 시스템을 소유할 수 있도록 지원합니다.
금융 도메인 집중: 금융 서비스 및 인접 산업에 집중하여 업종 이해도를 확보하고 있습니다.
소규모 시니어 팀 구조: 경력 중심의 소규모 팀 단위로 프로젝트를 수행합니다.
Globant
Globant는 스스로를 비즈니스 재창조에 집중하는 AI 네이티브 기술 서비스 기업입니다. 23년간의 혁신 경험을 바탕으로 AI 도입을 위한 AI 네이티브 서비스 플랫폼 Glob.AI를 운영하고 있으며, 35개국 이상에서 27,000명 이상의 인력(Globers)이 활동하고 있습니다. 산업별로 20년 이상의 전문성을 갖춘 8개의 AI Studio 체제로 고객 산업에 특화된 AI 서비스를 제공합니다..
AI 에이전트 개발 서비스
Globant는 Glob.AI OS를 중심으로 에이전틱 AI 도입을 지원합니다. Glob.AI OS는 기업 데이터, AI 모델, 에이전트형 솔루션을 안전한 환경에서 연결하고, 정적인 소프트웨어를 자율적이고 통제 가능한 시스템으로 전환하도록 설계된 기업용 플랫폼입니다.
4대 성과 축: 자율 운영(Autonomous Operations), 엔터프라이즈 자동화, 빠른 의사결정, 지속적 개선
3개의 에이전틱 스위트
CODA: 소프트웨어 개발 전 주기(SDLC)에 AI 에이전트, 로우코드 도구, AI 어시스턴트 적용
Navigate: 멀티 에이전트 기술로 장애를 예측하고 AMS·고객 지원 티켓을 처리하는 운영 및 인시던트 관리
FUSION: 고객의 기술 스택과 브랜드 보이스에 맞춘 GenAI 기반 마케팅(Globant AI Pods 제공)
산업별 에이전트: 은행·금융, 항공, 미디어·엔터테인먼트, 헬스케어, 호스피탈리티·여행, 자동차, 마케팅, 스포츠, 제조, 법률, SDLC, 지속가능 비즈니스, 에너지 등 13개 산업을 다루며, 은행·금융 분야에서는 신용 위험, 이상 거래 모니터링, 분쟁 해결, 채권 추심, 포트폴리오 분석, 고객 지원 등 14개의 샘플 에이전트를 제시합니다.
강점
산업별 AI Studio: 20년 이상의 산업 전문성을 갖춘 8개 스튜디오 체제
사람이 감독하는 AI 납품: AI Pods 기반의 인간 감독형 실행
통합 거버넌스 계층: Glob.AI OS를 통한 기업 전반의 AI 거버넌스
벤더 중립성: 멀티 클라우드, 멀티 모델 구조로 모델 제공사를 바꾸거나 어디서든 배포 가능
하이브리드 AI: 생성형 AI와 기호 AI를 결합하여 재현 가능한 구축, 버전 관리된 에이전트, 강화된 컴플라이언스 확보
대규모 엔지니어링 기반과 글로벌 파트너 네트워크: 27,000명 이상의 인력, 35개국 이상, 주요 클라우드·엔터프라이즈 플랫폼 파트너십
외부 평가: IDC MarketScape 리더, Brand Finance 순위
Plavno
Plavno는 2006년에 설립된 AI 퍼스트 소프트웨어 개발 기업으로, “AI는 실험이 아니라 실제로 작동하는 비즈니스 도구여야 한다”는 철학 아래 기업이 AI를 쉽고 실용적이며 수익으로 연결할 수 있도록 지원하고 있습니다. 150명 이상의 검증된 기술 전문가가 활동하고 있으며, 시니어 개발자 비율은 85%라고 밝히고 있습니다.
미국, 폴란드, 카자흐스탄, 영국 등 4개 거점에서 개발과 납품을 수행합니다.
AI 에이전트 개발 서비스
Plavno는 특정 워크플로에 맞춘 AI 에이전트의 전략 수립부터 개발, 연동, 운영 최적화까지 지원합니다.
핵심 서비스 6가지
AI 에이전트 전략 및 디스커버리: 워크플로와 문제점을 분석하여 에이전트가 가장 큰 효과를 내는 영역을 정의
맞춤형 AI 에이전트 개발: 데이터 조회, 응답 생성, 업무 실행을 수행하는 맞춤형 에이전트 구축
AI 에이전트 컨설팅: 에이전트 로직, 도구 사용, 모델 스택, 프롬프트 구조, 거버넌스 정의
에이전트 통합 서비스: CRM, ERP, 고객 지원 플랫폼, 데이터베이스, API, 지식 베이스와 연동
멀티 에이전트 시스템 개발: 리서치, 라우팅, 검증, 의사결정 지원을 수행하는 전문 에이전트 간 협업 설계
지원·모니터링·최적화: 프롬프트, 오케스트레이션, 안전성, 성능을 지속적으로 개선
강점
워크플로 맞춤 설계: 범용 어시스턴트가 아니라 특정 업무 흐름에 맞춰 에이전트를 설계합니다.
통합 아키텍처: LLM, 검색(RAG), 워크플로 로직, 시스템 연동, 휴먼 인 더 루프 통제를 결합합니다.
보안 및 안정성: 접근 통제, 폴백 메커니즘, 사람 검토 지점, 모니터링을 포함합니다.
시니어 중심 팀 구성: 개발자의 85%가 시니어 수준입니다.
20년의 엔지니어링 경험: 2006년 설립 이후 800건 이상의 프로젝트를 수행했습니다.
빠른 투입과 응답: 2~3주 내 팀 투입, 영업 문의에 24시간 내 회신을 안내합니다.
다양한 업종 경험: 12개 산업을 대상으로 합니다.
Qubika
Qubika는 기술 서비스 기업으로, 고객이 디지털 네이티브에서 AI 네이티브로 전환하도록 지원합니다. 20년 이상의 경험을 보유하고 있으며, 1,100명의 전문 인력이 8개 거점에서 활동하고 있습니다. 2025년 포괄적인 AI 전략을 발표했고, 2026년에는 Tryolabs를 인수했습니다.
Databricks 골드 티어 파트너(금융 서비스, 통신·미디어·엔터테인먼트·게임 전문 인증), AWS 어드밴스드 티어, Snowflake, Google Gemini Enterprise 파트너이며, Anthropic Claude Partner Network의 Preferred Partner(Services Track, 전 세계 40개사 중 하나)입니다. SOC 2와 ISO 27001 인증을 보유하고 있습니다.
AI 에이전트 개발 서비스
Qubika의 Agentic Factory는 산업별 문제를 해결하는 AI 에이전트를 구축하는 서비스입니다. 크로스 펑셔널 AI 팀이 고객사의 도메인 전문가와 함께 에이전트를 구축·배포·확장하며, 핀테크·은행, 헬스·생명과학, 하이테크·반도체, 엔터테인먼트, 교육 분야를 대상으로 합니다.
핵심 서비스 4가지
전략적 AI 기회 평가: Qubika AI Agent Framework로 ROI와 전략적 영향도에 따라 유스케이스 우선순위 결정
AI 에이전트 설계·구현: 재무 분석 에이전트, 신용 평가 에이전트 등 사전 구축 에이전트와 맞춤형 에이전트 제공
AI 인력 지원: 고객 내부 팀을 보완하는 크로스 펑셔널 Pod 구성
모델 최적화·벤치마킹: 특정 유스케이스에 대한 파인튜닝 및 성능 비교
GenAI 솔루션 4가지 범주: LLM 앱(고급 RAG, 사내 문서 검색, 계약서 작성, 재무 분석), 챗봇(텍스트·음성, 콜센터 어시스턴트), 자동화(문서 처리, 금융 프로세스 자동화, 시스템 연동), 에이전틱 워크플로(계획·실행형 다단계 워크플로)
Qubika Agentic Methodology(QAM): AI 에이전트에 맞게 조정한 애자일 방식으로, OWASP 기반 보안 우선(Security First), 모델 중심 스프린트, AI 우선 백로그 관리, 휴먼 인 더 루프로 구성됩니다.
QBricks(Databricks 기반 엔터프라이즈 액셀러레이터): 로우코드/노코드 워크플로 빌더, 사전 구축 에이전트와 워크플로 라이브러리, 비주얼 빌더, 평가 프레임워크, 엔드투엔드 관측 대시보드를 제공합니다. 에이전트는 LangGraph 환경에서 이식 가능하며, 데이터는 암호화와 접근 통제 아래 고객의 클라우드 환경 안에 유지됩니다.
강점
데이터·AI 통합 역량: Databricks 인증 엔지니어 250명 이상, 20년 이상의 데이터 경험을 보유하고 있습니다.
Anthropic 인증 FDE: Anthropic 인증을 받은 FDE(전방 배치 엔지니어)가 300명 이상이라고 밝히고 있습니다.
보안 및 규정 준수: SOC 2(Type 2), ISO 27001, GDPR·CCPA 정합성, 암호화, 접근 통제, OWASP 기반 보안을 갖추고 있습니다.
벤더 중립·이식성: 재사용 가능하고 특정 벤더에 종속되지 않는 코드, Qubika 도구 없이도 구동 가능한 에이전트를 지향합니다.
내장 평가와 관측: 평가 프레임워크와 엔드투엔드 관측 대시보드를 기본 제공합니다.
통합 팀 운영: Pod가 처음부터 고객과 하나의 팀으로 일합니다.
산업별 전문성: 은행, 금융, 보험, 헬스, 미디어, 하이테크·반도체 등 산업별 팀 구성
Softermii
Softermii는 산업별 맞춤형 소프트웨어를 개발하는 소프트웨어 개발 기업으로, 개념 검증(PoC)부터 운영 환경까지 맞춤형 AI 에이전트 개발을 제공합니다. 100개 이상의 프로젝트를 수행했고, 전 세계 100개 이상의 고객사와 협업했다고 밝히고 있습니다.
현재 미국, 폴란드, 독일, 우크라이나 등 4개 거점을 운영하고 있습니다.
AI 에이전트 개발 서비스
Softermii는 자체 에이전틱 AI 시스템 APEX를 활용하여 AI 에이전트를 빠르게 구축합니다.
에이전트 유형 6가지
대화형 AI 에이전트: 채팅·이메일·메신저 기반 고객 지원, 접수, 자격 심사, 온보딩(사람에게 이관 가능)
프로세스 자동화 에이전트: 문서 판독, 데이터 추출, 규칙 적용, 시스템 업데이트, 예외 표시 등 엔드투엔드 워크플로
의사결정 지원 에이전트: 데이터를 분석해 권고하되 최종 판단은 사람이 수행
멀티 에이전트 오케스트레이션: 보험금 심사, KYC, 공급망 등에서 전문 에이전트가 협업
음성 AI 에이전트: 인바운드 응대, 리마인더, 배차, 야간 접수
데이터 분석 에이전트: 상시 모니터링, 이상 탐지, 리포팅(사기, 임상, 운영 추적)
강점
고정 범위·고정 가격: 무제한 청구 없이 견적 오차는 자사가 부담한다고 밝히고 있습니다.
APEX 가속기: 인프라 작업을 60~70% 줄이고 처음부터 구축하는 것보다 3~6배 빠르다고 주장합니다.
도메인 전문성: 보험, 핀테크, 헬스케어, 물류 분야에 집중합니다.
지식재산 귀속: 맞춤 코드, 학습된 모델, IP는 고객이 소유하며, APEX 플랫폼 구성요소만 라이선스 형태로 제공됩니다.
자체 인프라 배포 가능: 고객 환경에 직접 배포할 수 있습니다.
출시 후 운영 지원: 모니터링, 최적화, 재학습을 지속적으로 수행합니다.
빠른 팀 구성: 1주 내 팀 구성이 가능하다고 안내합니다.
One Two Three
Nine Two Three는 미국 보스턴에 본사를 둔 AI 개발 전문 기업으로, 기업용 AI 에이전트 구축에 집중하고 있습니다. 75개 글로벌 고객사를 대상으로 150건 이상의 프로젝트를 수행하고 있습니다. SOC 2 Type II 인증을 보유하고 있으며, Inc. 5000, Clutch(2025·2026 Global, AI·ML·챗봇 부문 상위 기업), CES 혁신상, Family Choice Award 등의 평가를 받았습니다.
AI 에이전트 개발 서비스
Nine Two Three는 기업용 AI 에이전트를 발굴 단계부터 운영 환경 배포까지 구축하며, 기존 도구를 그대로 활용합니다.
구축 가능한 에이전트 유형
자율 워크플로 에이전트: 지원 티켓 분류, 보험금 청구 등 다단계 프로세스를 업무 규칙에 따라 수행하며, 사람에게 이관하고 상호작용을 통해 학습
대화형 AI 에이전트: 자사 데이터를 기반으로 출처를 인용하며 응답하는 사내 에이전트
문서 인텔리전스 에이전트: 청구서, 계약서, 규제 서류를 읽고 후속 작업 수행
4단계 진행 프로세스(총 12주 이내)
AI 디스커버리 워크숍: 워크플로를 매핑하고 병목을 정량화하여 ROI가 가장 높은 기회를 선정
검증·아키텍처 스프린트: 실현 가능성, 데이터 접근성, 연동 요건 확인
구축·연동: 에이전트를 개발하고 실제 데이터로 테스트하며, 모든 에이전트는 “27개 항목 평가 스위트”를 통과
배포·모니터링·확장: 모니터링 대시보드와 지속적 최적화
강점
소유권과 벤더 종속 없음: 코드, 학습된 모델, 지식 베이스를 고객이 소유하며 라이선스 비용과 플랫폼 종속이 없습니다.
설계 단계부터 컴플라이언스 반영: SOC 2 Type II, HIPAA·PCI DSS·SEC 규제 환경 대응
정확도 통제: RAG, 27개 항목 평가 스위트, 휴먼 인 더 루프 이관, 지속적 모니터링
기존 도구 연동: 새 플랫폼 도입 없이 현재 사용 중인 도구와 연동
후속 에이전트의 효율성: 인프라가 이월되어 이후 에이전트는 더 빠르고 저렴하게 구축할 수 있다고 안내합니다.
12주 이내 운영 도달: 명확한 기간과 비용 범위를 사전에 제시합니다.
신뢰할 수 있는 AI 에이전트 개발 파트너를 선택하는 방법
AI 에이전트 개발 기업 선택 방법
AI 에이전트는 모델 하나를 연결한다고 완성되지 않습니다. 업무 프로세스 이해, 시스템 연동, 평가, 운영 모니터링이 함께 이루어져야 하므로, 파트너 선정 단계에서 아래 네 가지 기준을 확인하시기 바랍니다.
인력 역량 및 AI 에이전트 전문성
AI 에이전트 개발은 LLM 활용 역량만으로 성공하기 어렵습니다. 업무 흐름을 설계하고, 외부 도구·API와 연동하며, 정확도와 환각을 검증하는 다양한 직무가 함께 필요합니다. 따라서 전담 AI·ML 엔지니어와 QA 인력의 규모 및 구성, 귀사 산업에서의 에이전트 구축 경험, PoC 이후 운영·유지보수를 담당하는 인력 체계를 확인하시기 바랍니다.
저희 LTS Group은 AI 전문가, 소프트웨어 엔지니어, QA 인력 500명 이상과 10년의 IT·AI 경험을 바탕으로 AI 에이전트를 개발하고 있습니다. 제조·공급망, 의료, 금융·은행, 유통·이커머스, 보험, 사이버보안 등 산업별 에이전트를 제공하며, 컨설팅부터 개발, 테스트까지 하나의 파트너가 책임지는 통합 생태계를 통해 고객이 여러 벤더를 조율해야 하는 부담을 줄이고 있습니다.
인증 및 규정 준수 기준
AI 에이전트는 기업의 내부 데이터와 시스템에 접근하므로 보안과 규정 준수가 필수 조건입니다. ISO 27001, SOC 2 Type II와 같은 정보보안 인증과 함께, AI 관리체계 표준인 ISO/IEC 42001, GDPR, 개인정보 보호법 대응 여부를 확인하시기 바랍니다. 아울러 접근 권한 통제와 감사 로그, 환각·오작동을 통제하는 테스트 및 휴먼 인 더 루프 절차가 갖춰져 있는지도 살펴보셔야 합니다.
저희 LTS Group은 Compliance-First 원칙에 따라 GDPR, HIPAA, ISO 27001, AI Act에 부합하도록 AI 에이전트를 구축합니다. 시스템 연동 단계에서 보안 및 접근 통제를 설정하고, 테스트 단계에서 기능·성능·보안·예외 상황을 점검하며 정확도, 응답 지연, 환각 통제를 평가하여 규제 환경에서도 안심하고 운영하실 수 있도록 지원합니다.
AI 분야에서 검증된 실적
고객 로고 나열만으로는 실제 역량을 판단하기 어렵습니다. 유사한 유형의 에이전트 구축 사례, 개선 수치와 측정 기준이 함께 제시된 성과, PoC에서 실제 운영으로 전환된 사례 수, 실명 고객 후기와 같이 검증 가능한 실적을 기준으로 평가하시기 바랍니다.
저희 LTS Group은 270건 이상의 프로젝트를 성공적으로 완료했으며, 97%의 고객이 재계약 및 협업을 이어가고 있습니다. AI 에이전트 분야에서는 발전기 매뉴얼을 기반으로 기술자의 부품 조회와 응답을 지원하는 Microsoft Teams 내 매뉴얼 AI 어시스턴트, 고객 데이터베이스에 LLM을 적용한 RAG 질의응답 시스템, 과제 채점과 즉각적인 피드백, 25개 산업 표준 기준 기반 역량 평가를 수행하는 교육 조교 시스템을 구축한 경험이 있습니다.
한국 기업과의 협업 경험
한국 기업과의 협업에서는 기술력만큼 소통과 운영 방식의 적합성이 중요합니다. 한국 고객 레퍼런스와 협업 기간, 한국어 지원 인력 및 한국 내 거점 보유 여부, 한국의 보안·개인정보 요건에 대한 이해와 보고·의사결정 체계에 맞춘 프로젝트 관리 경험을 확인하시기 바랍니다.
저희 LTS Group은 10년간 한국 고객과 협업하며 원활한 소통과 실행을 지원해 왔습니다. 한국 기업을 포함한 글로벌 고객과 함께해 왔으며 한국 지사를 통해 한국 고객의 요구에 신속하게 대응하고 있습니다.
LTS Group의 AI 에이전트 개발 서비스를 알아보십시오!
LTS Group의 AI 에이전트 개발 사례 연구
Generator 수동 AI 어시스턴트 개발
개요
고객사는 기술자들이 발전기 매뉴얼에서 더 빠르고 정확한 답변과 부품 조회를 할 수 있도록, Microsoft Teams 내에서 직접 작동하는 내부 AI 어시스턴트를 구축하고 있습니다. 이 시스템은 발전기, 엔진, 부품 매뉴얼을 완전히 수집(ingest)하고, 구조화된 부품 데이터와 의미론적 검색을 결합하여 출처가 명확한 답변을 인용과 API 연동 가능한 형태로 제공합니다.
국가: 미국
도메인: 산업 장비 서비스
AI 전문성: Agentic Hybrid RAG
개발 프로세스: 애자일
팀 규모 및 기간
인원: 6명
기간: 4개월
개발 환경: FastAPI, Typescript, Azure VM, CosmosDB
AI 기술
OpenAI 대형 언어 모델(LLM), 도구 호출, 에이전트 오케스트레이션
배포 환경
Kubernetes, Azure SQL DB
모니터링
RAG 지표, 시스템 지표
작업 범위
매뉴얼 및 부품 카탈로그 수집 파이프라인 구축
RAG 및 도구 기반 발전기 매뉴얼 AI 어시스턴트 개발
Microsoft Teams 통합 및 품질 평가
핵심 기능
엔진, 발전기, 부품 매뉴얼에 대해 자동 태깅, 페이지별 벡터 인덱스, 정규화된 SQL 부품 테이블을 포함한 수집 파이프라인 설계
출처가 명확한 인용과 무답변 대응 기능을 갖춘 대화형 Q&A 어시스턴트 제공 (트러블슈팅, 운영, 사양 지원)
정확한 부품 번호, 조립 정보, 크로스 모델 호환성까지 테이블 형태의 정밀 부품 조회 기능 구현
의미론 검색과 SQL 툴 간 라우팅을 담당하는 대리조정 계층 설계로 데이터 소스 간 결과 통합
기술자가 기존 워크플로우 내에서 매뉴얼과 부품 정보를 활용할 수 있도록 Microsoft Teams에 어시스턴트 통합
검색 품질을 측정하고 추가 최적화를 위한 최초 평가 프레임워크 구축
자주 묻는 질문
AI 에이전트는 일반 챗봇과 무엇이 다른가요?
전통적인 챗봇은 미리 설계된 시나리오에 따라 답변하며, 사전에 예상된 질문만 처리할 수 있습니다. AI 에이전트는 추론 능력을 갖추고 있어 여러 단계에 걸쳐 스스로 계획을 세우고, 도구/API를 호출하여 보고서 작성, 시스템 업데이트, 알림 발송 등 실제로 작업을 수행합니다. 단순히 답변만 하는 것이 아니라 시간이 지남에 따라 학습하고 개선될 수 있습니다.
기업용 AI 에이전트 개발 비용은 얼마인가요?
비용은 단순 규칙 기반인지, 자율적 추론 능력을 갖췄는지 에이전트의 복잡도, 통합이 필요한 시스템 수, 요구사항에 따른 맞춤화 수준에 따라 달라집니다. LTS Group은 초기 상담을 통해 구체적인 니즈를 파악한 후 적합한 견적을 제공해 드립니다.
AI 에이전트 프로젝트의 구축 기간은 얼마나 걸리나요?
아이디어를 검증하기 위한 PoC/MVP의 경우, 일반적으로 수 주 정도가 소요됩니다. 기업 시스템에 깊이 통합되는 완전한 형태의 AI 에이전트는 규모와 복잡도에 따라 수개월이 소요될 수 있습니다.
마무리
AI 에이전트 개발 기업마다 접근 방식은 다르지만, 이번에 살펴본 기업들의 공식 자료에서는 공통된 흐름이 확인됩니다. 다수의 기업이 거버넌스와 보안, 휴먼 인 더 루프, 기존 시스템 연동(MCP·A2A 등)을 핵심 요소로 제시하고 있으며, 단순 PoC에 그치지 않고 운영 단계까지 책임지는 구조를 강조합니다.
따라서 파트너를 선정하실 때에는 인력 역량과 AI 에이전트 전문성, 인증 및 규정 준수 수준, 검증 가능한 실적, 한국 기업과의 협업 경험을 종합적으로 확인하시기 바랍니다. 특히 로고 나열보다 성과 수치와 측정 기준이 함께 제시된 사례를 요청하시고, 작은 범위의 PoC로 먼저 검증한 뒤 확장하는 방식을 권장드립니다.
저희 LTS Group은 AI 전환 컨설팅부터 맞춤형 AI 에이전트 개발, 시스템 통합, 테스트, 배포 후 최적화까지 하나의 파트너가 수행하는 통합 서비스를 제공하며, 10년간 한국 고객과 협업해 왔습니다. AI 에이전트 도입을 검토하고 계시다면 아래 서비스 페이지를 참고하시고, 편하게 상담을 요청해 주시기 바랍니다.